MinerU

2天前发布 3 00

MinerU是一个开源文档解析与阅读工具,把PDF、扫描件、图片和Office等文件转成可检索的Markdown,支持按页按块续读与稳定引用定位,默认本地解析,适合Agent阅读、长文档处理和批量转换场景。

收录时间:
2026-11-20

MinerU是一个开源文档解析工具,主要用来把PDF、图片转成可检索内容,服务于要读文档的人。它由opendatalab团队维护,以仓库形式开放源码。和只管把文件拆成文本的通用解析器不同,它把解析与阅读接成一条链路:内容既能转成Markdown供分析,也能按页、按块接着往下读,并留下稳定的引用位置。对隐私敏感的场景,它默认在本机完成解析,只有命令里显式启用远程才会上传文件,本地失败也不会悄悄改道。项目提供Python SDK、V1 API、无状态批处理、Router和网页界面,新版还补上行内公式、复杂版式与跨页表格识别。看清它覆盖的格式与环节,就知道该不该换掉手头流程。
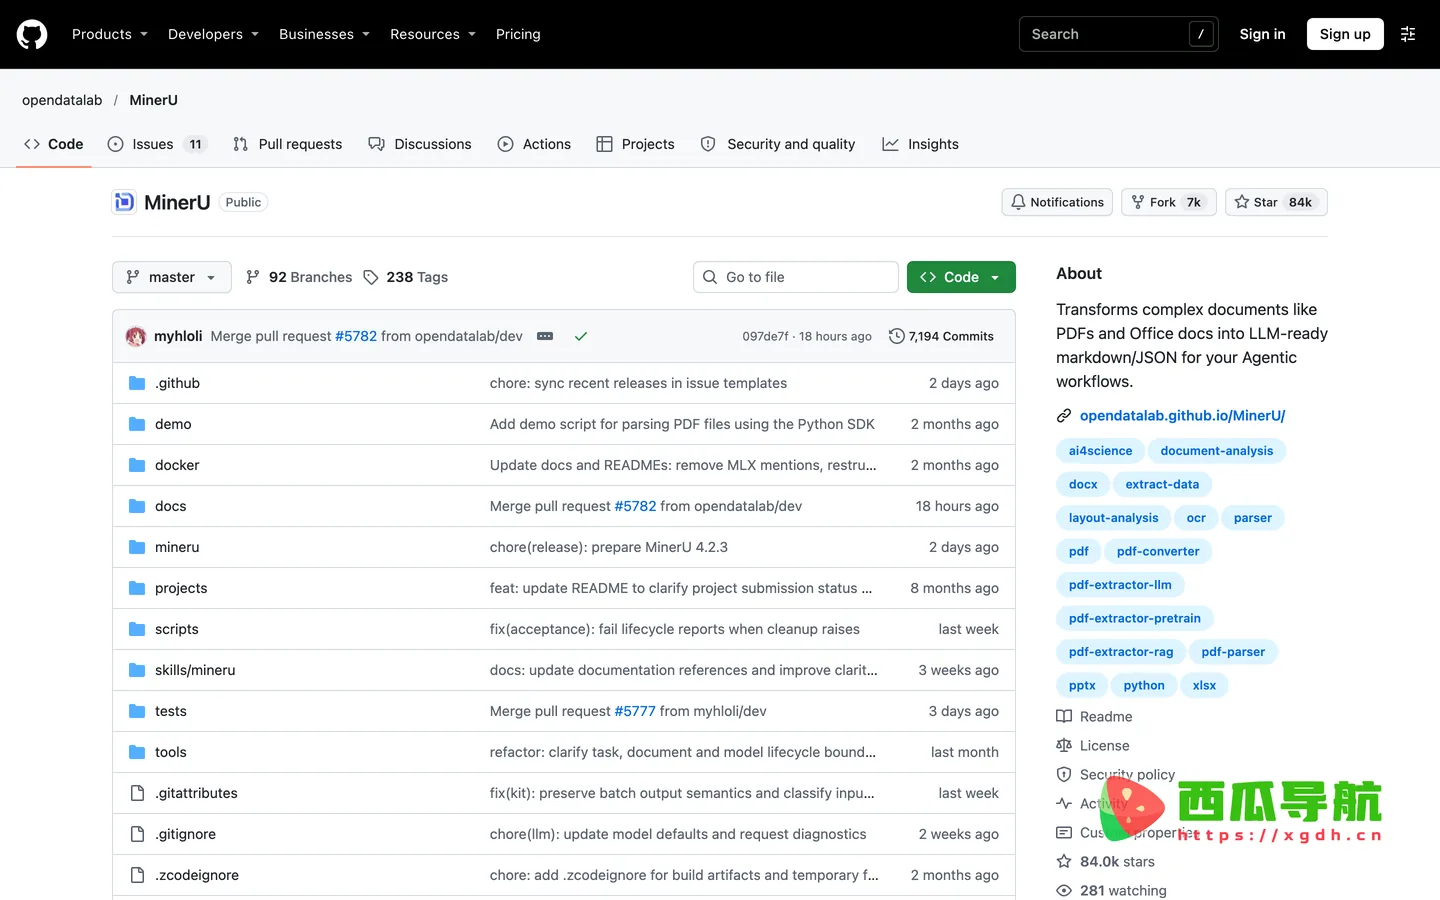
站点名 首页截图

主要功能

  • 多格式转 Markdown:PDF、扫描件、图片、Word、PPT、Excel、RTF、OpenDocument、EPUB、OFD、HTML、MHTML、CSV 都能转成文本,扫描件走 OCR。
  • 文档库与引用定位:发现文件、缓存结果、搜索已索引内容,并保留 doc:{shortid}/tier:{tier}/page:{pageno}/block:{blockno} 定位符供引用与回读。
  • 长文档续读:以页、块为单位接着读,不必把整篇塞进上下文;也能取页面或块的图片做视觉核对。
  • 解析质量分级:行内公式、复杂版式与跨页表格合并更准;Flash 档借助 Tagged PDF 与 PDF/UA 结构语义改善阅读顺序。
  • 工具形态齐全:Python SDK、V1 异步任务接口、无状态批处理、多服务 Router 与 Gradio 网页界面;新版支持原文与结果双向跳转、大纲导航。
  • 模型与算力自配:小模型用 ONNX 或 Torch,视觉模型用 llama.cpp、vLLM 或 LMDeploy,按设备自动加速。

适合谁用

  • 要把 PDF、扫描件批量转成可分析文本的开发者与数据分析者。
  • 让 Agent 读长文档、又需要稳定引用出处的团队。
  • 处理论文、财报等多表格多公式材料的学生与研究者。
  • 看重本地解析、不愿把文件外传的隐私敏感用户。
  • 想自选模型引擎与算力、自行搭解析服务的工程师。

主要入口

首屏是项目名与简介,往下为 Overview 概览,交代版本更新与能力边界。Try online 能在浏览器里先跑一遍解析器,无需装环境;English 与简体中文可切换。README 按 Quick Start、Supported Inputs 等小节展开,对应上手与支持格式。再往下是续读、按定位符读取、查看页面图片和搜索等阅读说明;Privacy Rules、Telemetry、Quality Tiers 小节讲清隐私与档位规则。侧边另有 Discord、WeChat 社群。

同类对照

  • 和通用 PDF 解析库比:它不只出文本,还带文档库、续读与稳定定位符,适合把内容喂给 Agent 并回引出处的场景。
  • 和纯 OCR 工具比:它把扫描识别、版式公式与跨页表格放进同一条链路,材料类型杂时少来回切换。
  • 和在线转换服务比:它默认本地解析、模型引擎可自选,文件敏感或量大时更合适选它。

数据统计

数据评估

MinerU浏览人数已经达到3,如你需要查询该站的相关权重信息,可以点击"5118数据""爱站数据""Chinaz数据"进入;以目前的网站数据参考,建议大家请以爱站数据为准,更多网站价值评估因素如:MinerU的访问速度、搜索引擎收录以及索引量、用户体验等;当然要评估一个站的价值,最主要还是需要根据您自身的需求以及需要,一些确切的数据则需要找MinerU的站长进行洽谈提供。如该站的IP、PV、跳出率等!

关于MinerU特别声明

本站跳跳兔导航提供的MinerU都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由跳跳兔导航实际控制,在2026年11月20日 上午10:35收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,跳跳兔导航不承担任何责任。

相关导航

暂无评论

您必须登录才能参与评论!
立即登录
none
暂无评论...