处理 PDF、扫描件和各类办公文档时,把内容准确读出来往往只是第一步,能否保留标题层级、表格结构、公式语义以及可回溯的页码位置,才真正决定后续整理与引用的效率。MinerU 正是围绕这条链路打造的开源文档解析工具,它把解析、OCR、检索、检查与引用收拢到一套统一能力里,既能把文件内容转换成便于分析的 Markdown,也能让使用者按页或按块继续深入长文档,而不必将整份文件一次性塞进上下文。对于经常和论文、报表、扫描资料打交道的人来说,它提供的是一种更克制也更可控的工作方式:默认在本地完成解析,需要时才考虑远程,并把每一次读取的位置都记录成稳定的定位器。下面从它是什么、能做什么、适合谁用、怎么上手等角度,把这套工具完整梳理一遍。
MinerU是什么?
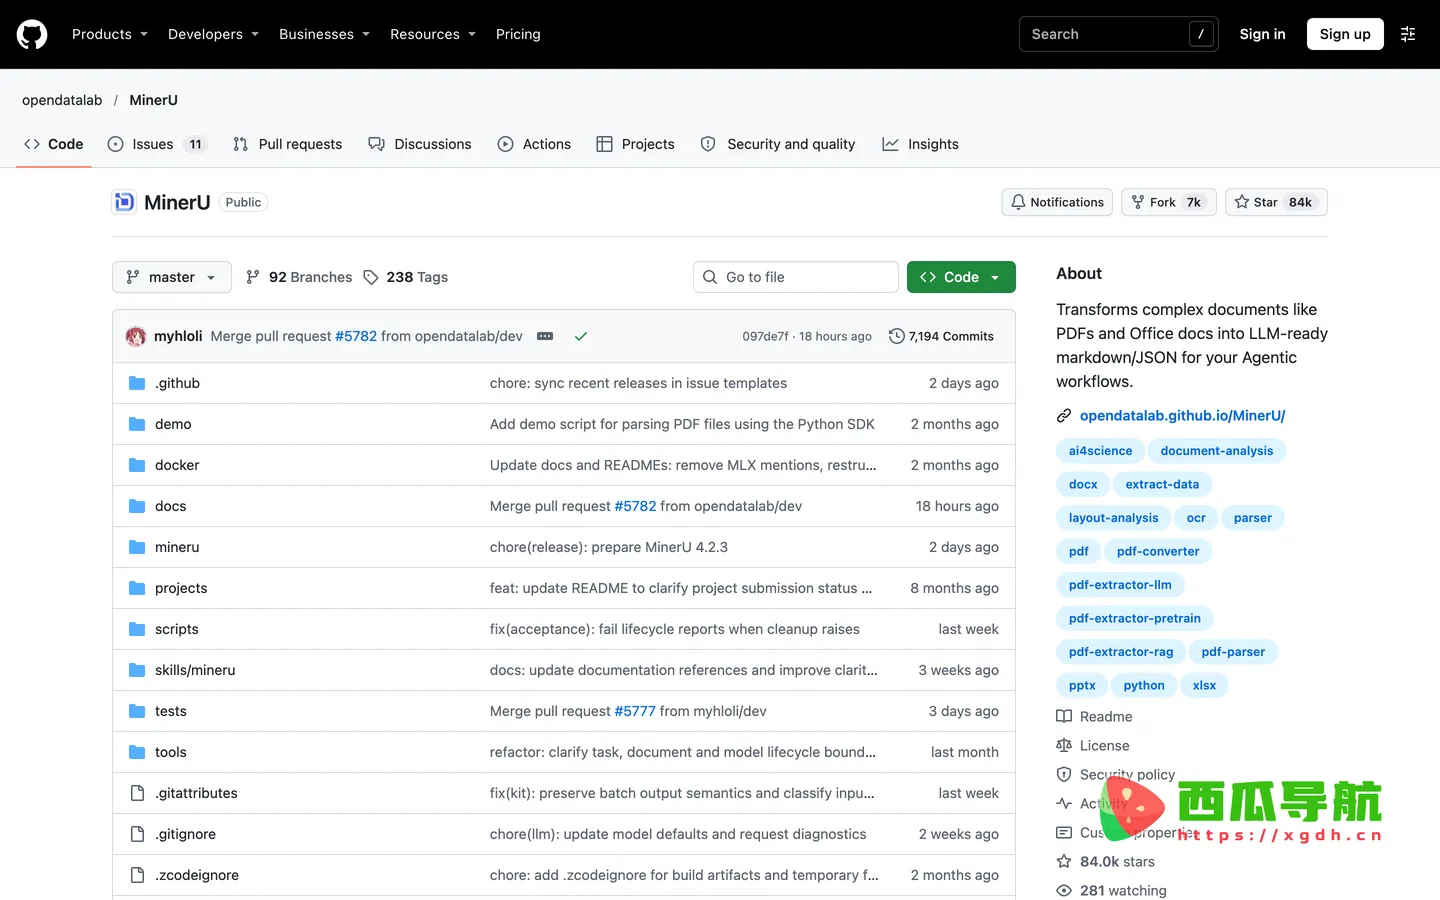
MinerU是一个开源文档解析与阅读工具,主要用来把 PDF、扫描图像以及 Word、PowerPoint、Excel、RTF、OpenDocument、EPUB、OFD、HTML、MHTML、CSV 等格式的文档内容准确提取出来,并转换成便于加工的结构化文本,服务于需要阅读、检索、总结、引用和处理长文档的研究者、开发者与内容工作者。它并不满足于把文字从页面里抠出来,而是把整条文档链路都纳入考虑:从文件发现与结果缓存,到内容搜索、按页或按块继续阅读,再到保留可稳定回溯的引用定位器,都可以在同一套能力中完成。值得注意的是,MinerU 默认在本地解析文档,只有命令显式带上远程参数时才会把文件送去远端,这一设定让它在隐私敏感的场景中也有立足之地。
核心功能
- 多格式解析——覆盖 PDF、扫描图像以及 Word、PowerPoint、Excel、RTF、OpenDocument、EPUB、OFD、HTML、MHTML、CSV 等常见文档格式,把不同来源的内容统一转成可供分析的文本。
- OCR 与结构化提取——针对扫描件和图片做文字识别,同时保留标题层级、表格结构与行内公式语义,跨页表格还能自动合并,让复杂版面的内容不再支离破碎。
- Markdown 转换——把解析结果整理成干净的 Markdown,方便直接用于后续分析、二次编辑或导入知识库,省去手工排版的麻烦。
- 文档库与稳定定位——支持发现文件、缓存结果、搜索已索引内容,并用形如 doc:{shortid}/tier:{tier}/page:{pageno}/block:{blockno} 的定位器固定引用位置,便于回头核查与再次读取。
- 长文档续读——面对篇幅很长的资料,可以按页或按块继续读取并检索页面或块图像,而不必把整份文件一次性加载进上下文,上下文压力更小。
- 统一工具入口——同时提供 Python SDK、V1 接口、无状态批量转换、多服务 Router 与基于 Gradio 的 WebUI,命令行也以 mineru 作为统一命令入口,不同使用习惯都能找到合适的调用方式。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 学术研究者 | 批量解析论文与资料,保留公式和表格结构,按页块定位并引用原文 | ★★★★★ |
| 内容整理者 | 把扫描件和办公文档转换为 Markdown,沉淀进笔记或知识库 | ★★★★☆ |
| 开发者 | 通过 SDK 或接口把解析能力接入自己的文档处理流水线 | ★★★★☆ |
| 数据工程师 | 处理长文档与复杂版面,做批量转换和内容检索 | ★★★★☆ |
| 隐私敏感用户 | 依赖本地解析处理内部资料,避免文件默认上传远端 | ★★★★☆ |
操作指南
- 准备运行环境。根据自己机器的操作系统选择对应的安装方式,Windows 与 Linux 上兼容的 Intel、AMD、NVIDIA 显卡会自动获得 ONNX 加速,macOS 则沿用已有的 MPS/Metal 支持,安装前先确认硬件与依赖是否满足条件。
- 完成安装与基础配置。依照项目文档把解析所需的小模型和视觉语言模型配置到位,小模型可选 ONNX 或 Torch,视觉语言模型可选 llama.cpp、vLLM 或 LMDeploy,按需选择即可,不必一次性全部装上。
- 找到入口并开始解析。安装完成后即可通过统一命令入口调用,也可以在 WebUI 界面里点击 立即使用 上传文件;想进一步了解项目说明与在线试用方式,可访问 MinerU。
- 选择合适的解析层级。日常阅读直接省略层级参数,让工具采用常规质量;基于解析服务器的场景会先尝试标准档、再退到基础档,高级档不会被默认启用,需要时再自行指定。
- 处理长文档与引用。文件较长时不要一次性读入,改用按页或按块续读,并保留系统给出的定位器,后续做总结、摘录或答复问题时都能回溯到具体位置。
- 关注隐私与失败处理。默认全部在本地完成解析,只有显式加上远程参数才会上传;本地失败不会悄悄转远端,远程失败且本地仍可满足时才可能回退,涉及上传前务必先取得明确同意。
支持平台
从可见信息看,MinerU 提供基于 Gradio 的 WebUI 界面并支持在线试用,因而可以通过浏览器直接使用;同时它提供统一的命令行入口 mineru,适合本地脚本化调用。在操作系统层面,项目提到 Windows 与 Linux 上兼容显卡的自动 ONNX 加速,以及 macOS 上既有的 MPS/Metal 支持,也就是说这三大主流桌面系统都在支持范围内。此外,Python SDK 与 V1 接口让它可以被集成进更上层的客户端或服务,但站方并未列出独立的小程序或浏览器插件形态,若需要这类入口,以项目后续说明为准。
产品定价
站方未公开价格信息,以站内为准。从现有材料看,MinerU 以开源项目的形式提供,强调本地解析与自主配置模型,具体的授权范围、使用条款与可能的增值服务,建议以项目仓库内的说明为准,这里不做推测。
常见问题
Q:MinerU 默认会把我的文档上传到远端吗?
不会。MinerU 默认在本地解析文档,只有命令显式带上远程参数时才会把文件送去远端处理。即便配置了远程解析,在用户明确同意之前也不应上传;本地解析失败不会静默回退到远程,只有远程失败且请求仍能在本地满足时,才可能回退到本地。
Q:读取一份已经解析过的文档,会重新解析一遍吗?
不会。执行读取命令时,MinerU 会优先读取缓存中质量较好的结果,而不是从头发起一次新的解析。配合文档库的文件发现与结果缓存,重复读取同一份资料既省时间,也让按页或按块的续读更加连贯。
Q:常规阅读质量不可用时该怎么办?
可以先检查服务器状态,再把可选方案摆出来权衡:使用远程解析并明确授权上传、在硬件条件允许时启动或配置本地解析服务器、明确接受质量较低的本地 flash 档,或者授权回退到非 MinerU 的解析器。此时更稳妥的做法是停下来等待使用者决定,而不是为了把任务跑通就擅自换用别的解析器。
开发者小结
综合来看,MinerU 的取舍很清晰:它把力气花在解析质量、结构保留与引用可回溯上,用页块定位、结果缓存和本地优先来换取长文档场景下的可控性,而不是追求花哨的交互或轻量化的体积。它适合那些经常与论文、报表、扫描资料打交道,且在意表格公式还原与内容引用准确性的使用者;对于只是偶尔看几页 PDF、对结构化没有要求的人来说,这套能力显得偏重,部署与模型配置也需要一定的动手成本。另一个边界在于远程与本地的抉择:涉及上传时必须先取得授权,质量档位的选择也应交给明确的意图而非默认行为。理解这些前提,就能判断它是否值得进入你的文档工作流。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...