LongCat 是美团 LongCat 团队放在开源社区的对话模型,仓库名 LongCat-Flash-Chat,定位很清楚:总参数 5600 亿的混合专家模型,按上下文动态激活 186 亿到 313 亿参数,平均约 270 亿;它是一个不做长思考的基础模型,能力重心压在智能体类任务上。官方给出的推理指标是每秒 100 个 token 以上,实现路径也写在说明里:零计算专家按 token 重要性分配算力,Shortcut-connected MoE 拉长计算与通信的重叠窗口,再用 PID 控制器调节专家偏置把平均激活量稳住。对做应用的人来说,真正值得看的是权重、部署方式、工具调用结构和在线体验入口被收在同一个仓库里,拿来就能跑,跑不动也能先从网页版试手感,不用先赌一次采购。
LongCat是什么?
LongCat 是一个开源的混合专家大语言模型,主要用来做对话、工具调用和智能体任务,服务于想在自己产品里接入模型能力、又希望看清底层实现的开发者与小团队。它的总参数规模是 5600 亿,但并不靠全量参数干活:模型按上下文需要动态激活 186 亿到 313 亿参数,平均约 270 亿,把算力集中在真正重要的 token 上。为了把这条动态预算稳住,官方用 PID 控制器调节专家偏置,让每个 token 的平均激活量保持在设定水位。它属于非思考型基础模型,也就是不做长链推理、直接给结果的那一类;官方评估时把它和 DeepSeek-V3.1、Qwen3-235B-A22B、Gemini2.5-Flash、Claude4-Sonnet 的非思考模式并列,并强调优势在智能体任务上。仓库把技术报告、快速开始、部署说明、在线对话入口放在一起,读完能判断,跑起来能验证。
核心功能
- 动态算力分配——同一个模型对简单提问少算、对复杂任务多算,省下来的算力直接换成吞吐,你不必为一句寒暄付出满配开销。
- Shortcut-connected MoE——把计算与通信的重叠窗口拉长,跨卡等待变短,官方给出的推理速度是每秒 100 个 token 以上。
- 非思考型输出——不先写一段推理再给答案,首字延迟和输出长度更可控,适合直接面向终端用户的对话入口。
- 工具调用——仓库把 Messages 和 Tools 单独成节,说明函数调用是一等能力,智能体流程里可以直接对接外部接口。
- 可自托管的部署路径——从环境准备到启动服务有独立章节,权重和推理服务在自己手里,不必把请求转给第三方。
- 在线对话入口——官方给了网页版对话,不装环境也能先试手感,用来判断值不值得继续投入。
- 技术报告与引用信息——评估口径、对比对象和引用格式都写在仓库里,做技术选型时能追到原始依据。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 应用开发者 | 想给产品加自托管的对话能力,先按部署章节把服务跑通,再接自己的业务接口 | ★★★★☆ |
| 智能体方向团队 | 需要模型稳定调用外部工具,看重函数调用与多轮消息的组织方式 | ★★★★☆ |
| 技术选型负责人 | 用在线入口和非思考模式横向对比几家模型,先看延迟与任务完成度再做决定 | ★★★☆☆ |
| 高校与研究同学 | 想读一份把训练与推理优化写得较细的模型说明,配合技术报告做复现实验 | ★★★★☆ |
| 成本敏感的小团队 | 希望按自己的硬件规划推理开销,不接受按调用量计费的托管接口 | ★★★☆☆ |
操作指南
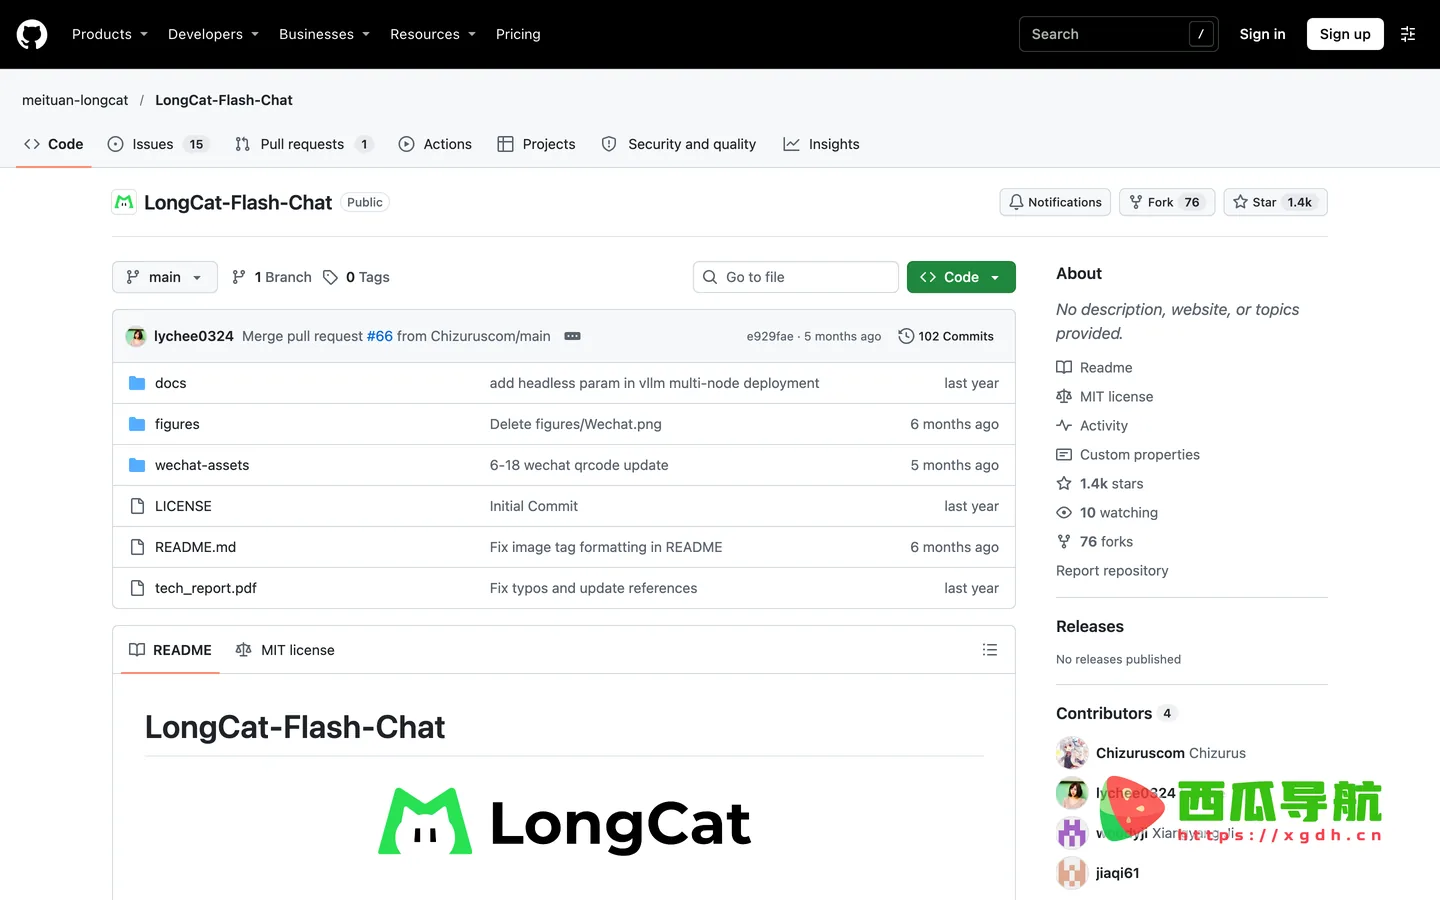
- 先打开仓库首页,把 Model Introduction 和 Evaluation Results 两节读完,确认 5600 亿总参数、平均 270 亿激活和每秒 100 个 token 这些指标与你的场景对得上。
- 进 Chat Website 章节,点 立即使用 进官方对话页,用最熟悉的三五个业务问题试一轮,重点看回答是否符合非思考模型的直接风格。
- 需要接进产品时转到 Quick Start,按文档准备运行环境,权重、依赖和启动命令都在这一节里。
- 看 Deployment 章节决定部署形态,单机还是多机、精度与显存怎么配,文档给了对应说明,按配置表逐项核。
- 读 Tools 与 Messages 两节,把函数调用的请求结构抄进联调脚本,先跑通一次工具调用,再谈并发和超时。
- 对照 Usage Considerations 过一遍使用注意事项,把不适合的场景提前排除,避免上线之后再返工。
- 需要对外说明或引用时,用 Citation 章节给出的格式;仓库地址在这里:LongCat。
整套流程下来,真正费时间的不是启动服务,而是第 5 步的结构适配:把已有业务的参数映射成多轮消息,再把可调用的接口注册进去。建议先用最小的一条消息加一个工具试通,再逐步加字段。
支持平台
仓库里明确能看到三种使用方式:一是官方提供的网页对话入口,打开浏览器就能用;二是自托管的推理服务,按部署文档在自己机器上拉起;三是接口形式,通过消息结构与工具调用把模型接进自有系统。桌面客户端、手机客户端、小程序、浏览器插件这四类形态,站方没有明确列出,仓库里也找不到对应的下载或安装入口,需要的话只能自己基于接口封装。另外注意评估数据的口径:对比模型同样在非思考模式下测试,跨模型比较时要对齐这一条,否则拿思考模式的分数来比会失真。
产品定价
仓库内没有出现价格、套餐、额度或试用期限一类的说明,模型权重以开源形式发布,官方也没有列出任何收费档位。站方未公开价格信息,以站内为准。对打算自托管的人来说,真正的成本在硬件与运维:显存占用取决于你选的部署形态与精度,长期运行的电力、带宽和人力也要自己算。想把成本压下来,比较稳的做法是先在网页入口验证效果,确认值得投入,再决定买几张卡、上几台机器。
常见问题
Q:总参数 5600 亿,是不是必须用很大的机器才跑得动?
总参数决定权重体积,但每次推理只激活其中一部分,官方给的区间是 186 亿到 313 亿,平均约 270 亿。实际需要多少显存,仍要看你选择的精度、并行方式和部署形态,部署章节给了对应说明,建议按那一节的配置项逐条核对,再决定用几张卡,不要按总参数直接推算。
Q:它不做长链推理,复杂任务会不会跟不上?
官方对它的定位是非思考型基础模型,能力重心放在智能体任务上,也就是把任务拆成工具调用和多轮交互去完成,而不是靠一段很长的内部推理。评估里它和几家主流模型的非思考模式并列比较,对标口径是同一档。如果你的场景确实需要长链推导,应该先在自己的数据集上实测,再判断是否合用。
Q:接进现有系统要改多少代码?
消息结构和工具调用在仓库里单独成节,接入方式是按它的请求格式组织多轮消息,并把要用的外部接口注册进去。已有系统只要能把请求转成这套结构,改动集中在适配层,业务逻辑不用重写。具体字段和示例在 Tools 与 Messages 两节,照着抄一份联调脚本,先跑通一次调用再扩展。
开发者小结
LongCat 的取舍写在名字和架构里:用动态激活把 5600 亿参数的模型压到平均 270 亿的算力水位,用 Shortcut-connected MoE 换更长的通信重叠窗口,代价是调度逻辑更复杂、对部署环境更挑剔;放弃长链思考换来更短的延迟和更可控的输出长度,代价是在需要多步推导的任务上不如思考型模型稳。它适合自托管、要接工具、看重吞吐的场景,不适合只想调一个接口就问复杂推理问题的用法。评估数字来自官方,横向对比时记得对齐非思考模式这一口径。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...