
反向词典
反向词典WantWords是一个开源在线反向词典,按一段意思描述反查语义相符的单词,帮助想不起词的人、语言学习者和选词困难者找到合适的词,并提供小程序、论文引用与可下载的模型数据,可直接体验也能自行搭建。
 Firecrawl
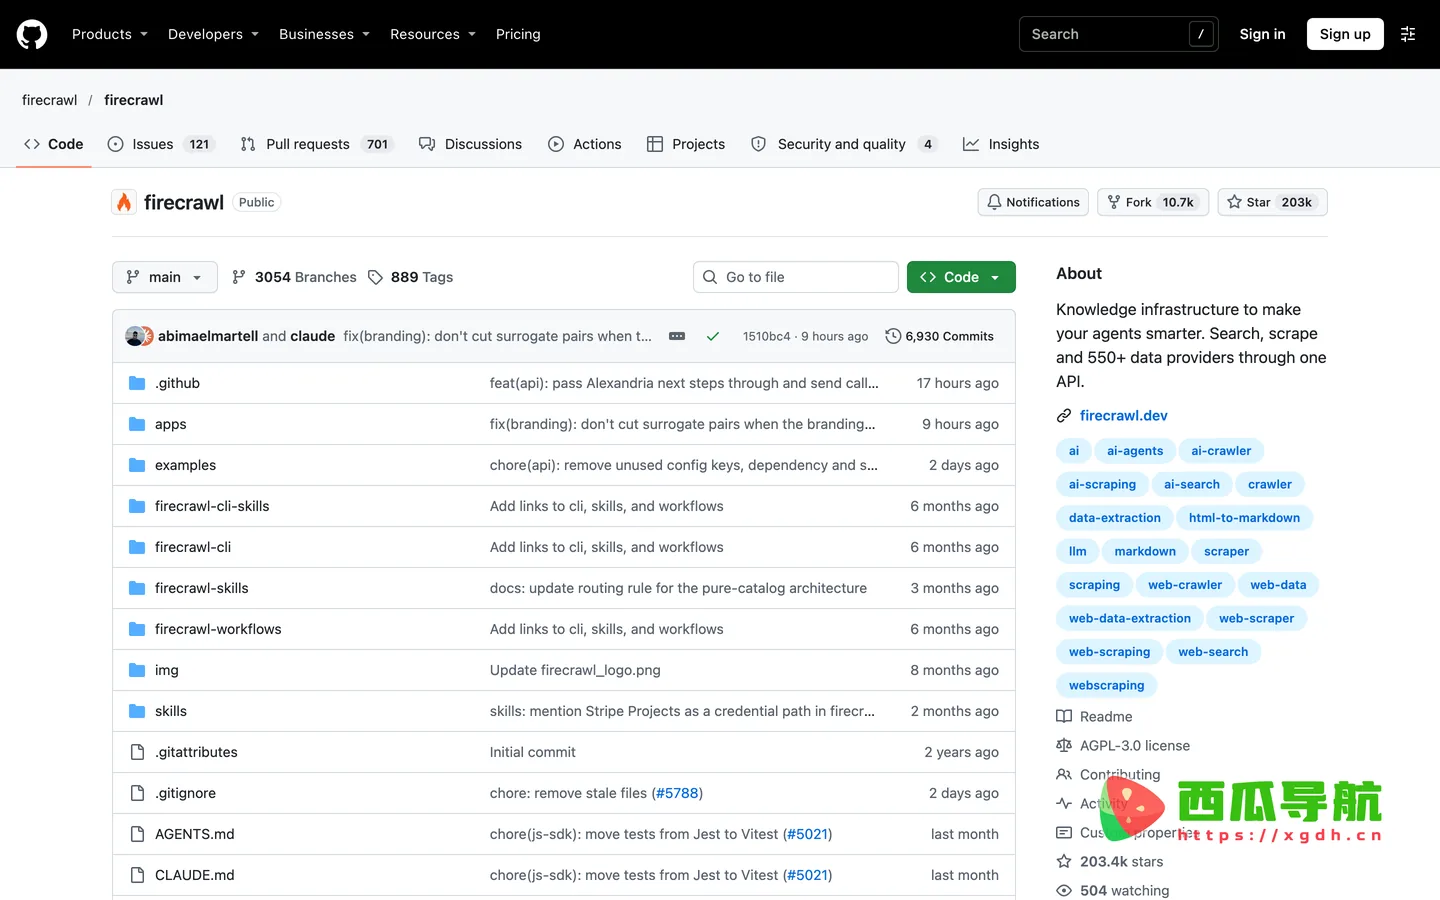
是一个面向AI智能体的开源网页抓取工具,主要用来把网页转成干净数据,服务于批量网络取数的开发者。它以开源项目起家,同时提供托管服务,把搜索、抓取、交互和文档解析收在同一套接口里。和常见的单页抓取脚本不同,它面向规模化场景:官方数据称覆盖约96%的网页,包含大量依赖脚本渲染的页面,数百万页请求下P95延迟约3.4秒;代理轮换、任务编排、速率限制与脚本拦截都由它兜底,调用方不用自己搭代理池。输出按大模型习惯给,可选干净Markdown、结构化JSON或截图,减少送入模型的冗余内容。技能目录也能直接装进智能体环境,适合想快速验证想法的人。
Search 搜索:按关键词检索全网,并直接取回结果页的完整正文,而不只给标题和链接,适合先把范围圈出来再定抓取目标。
Scrape 抓取:把任意地址转成 Markdown、HTML、截图或结构化 JSON,同一页按需切换产出格式,归档、语料、快照都覆盖。
Interact 交互:先加载页面,再用自然语言或代码让它点击、滚动、输入、等待、按键,拿到必须操作后才出现的内容。
Parse 解析:把 PDF、DOCX 等文档转成干净 Markdown 或结构化 JSON,报告和手册也能进同一条数据管线。
Crawl 与 Map:Crawl 一次请求抓下整站页面,Map 快速列出某个站点下已发现的链接,动手前先摸清结构。
Batch Scrape 与 Monitor:批量抓取可异步提交上万条地址,Monitor 在内容变化时通知,适合盯公告、价格、库存这类会变的字段。
Alexandria:托管服务把智能体接到 550 多个数据源和专用索引上,网页之外的数据需求一并解决。
首屏是项目说明区:Why Firecrawl 一段先讲可靠性、速度、输出格式,接着 Feature Overview 对照表把搜索、抓取、交互三类核心端点与解析、建图等能力列在一起,一眼看清各自用途。往下 Quick Start 指向注册获取调用凭证和在线试玩;Features、Alexandria、SDKs、Integrations 几块分别展开功能细节、外部数据源、各语言封装和第三方对接,Resources 是文档资料,末尾 Open Source vs Cloud 对照开源与托管。
本站跳跳兔导航提供的Firecrawl都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由跳跳兔导航实际控制,在2026年11月21日 上午7:52收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,跳跳兔导航不承担任何责任。