中国亲戚关系计算器

2天前发布 5 00

中国亲戚关系计算器是一个开源的中文亲戚称谓计算工具,把亲属链条换算成该喊的称呼。它提供选项模式和语句模式,输入"爸爸的哥哥"即可算出称谓,还支持逆向反查、兼容各地叫法,既能在线试算,也能作为 npm 包接入项目。

收录时间:
2026-11-20
中国亲戚关系计算器中国亲戚关系计算器

中国亲戚关系计算器是一个开源的亲戚称谓计算工具,主要用来根据亲属链条算出该喊的称呼,服务于想理清亲戚关系的普通人。它托管在 GitHub 上,代号 relationship,以 relationship.js 这个包发布,既能在网页里当脚本引入拿到全局方法,也能装进 Node.js 项目调用。和只摆一张静态称谓表的网站不同,它把算称呼做成一套可复用的引擎:既有按条件逐项点选的选项模式,也有把”爸爸的哥哥”这类整句话丢进去的语句模式,还支持顺着结果反查。这种既能随手一查、又能嵌进别人产品的身份,让它在同类工具里显得实用:不必先搞懂辈分规则,把知道的关系拼出来,它就替你算出那声称呼。
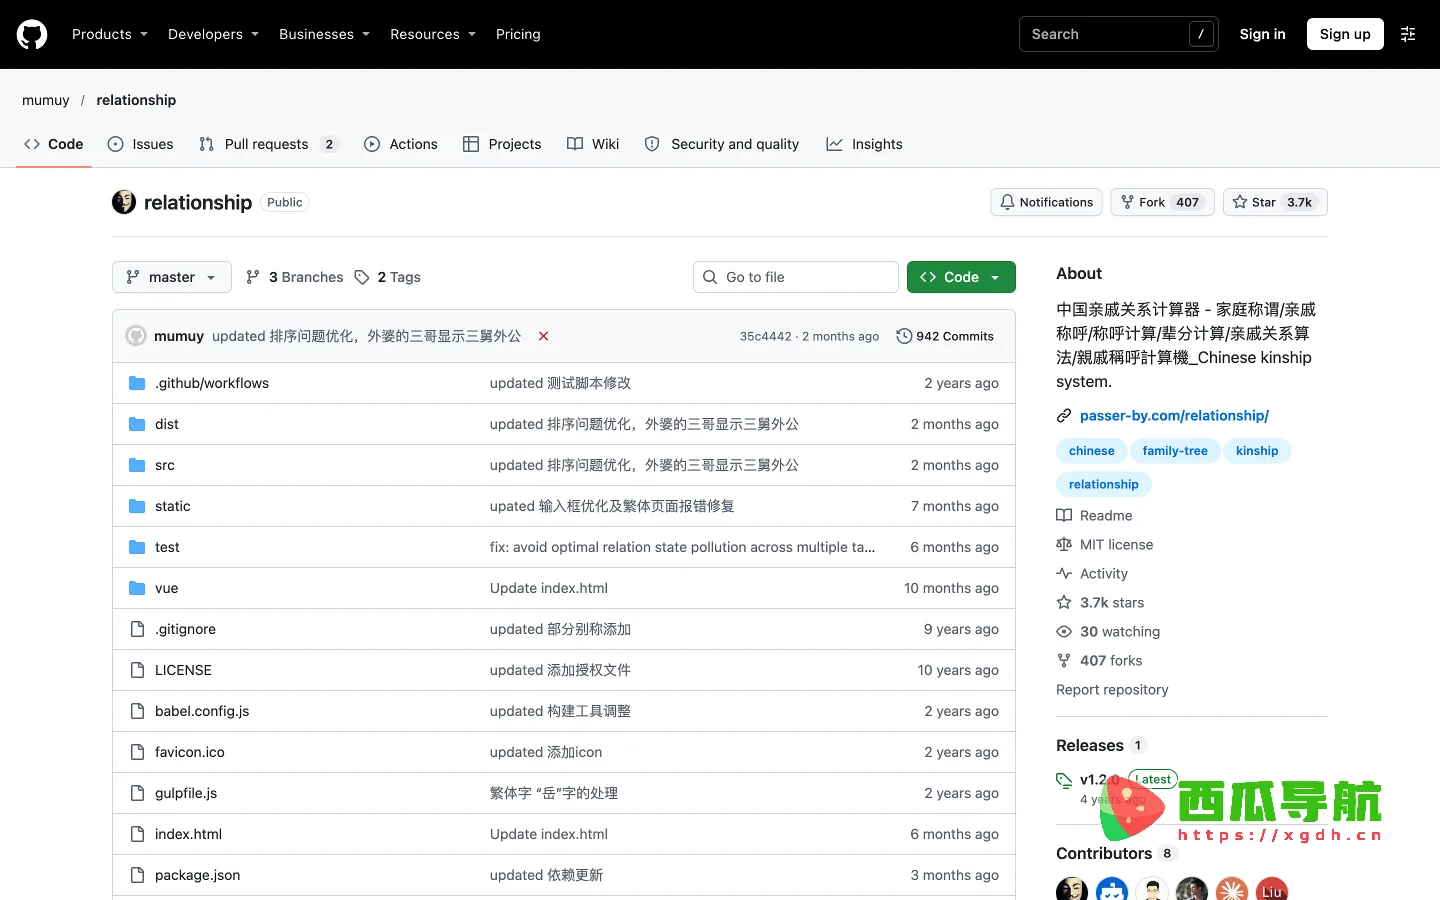
站点名 首页截图

主要功能

几点功能彼此独立,也能拼在一起用。

  • 选项模式:对应 relationship(options),把关系拆成一步步的条件,按提示逐项选定后得到称呼,适合已知”是谁的谁”、想稳稳把链条搭出来时用。
  • 语句模式:对应 relationship(exptession),支持”xxx是xxx的什么人””xxx叫xxx什么””xxx如何称呼xxx”这类句式,整句写进去即可解析,适合习惯直接把关系说清楚的人。
  • 逆向查找与快捷输入:算法支持顺着关系反查该喊什么;输入框兼容”老爸””爹地””老爷子”等叫法,配合快捷输入按键,点几下就完成输入,照顾了不同地域的说话习惯。
  • 数据表与自定义模式:relationship.data 暴露当前数据表,relationship.dataCount 给出数据量,relationship.setMode 允许传入自己的数据覆盖,适合想把这套算法接到别的场景里的开发者。
  • 分歧说明与原理教程:讲清南北方、地区间的称谓差异和多关系跨辈分的取值,配上算法实现原理,遇到”到底该喊哪个”的争论时有据可查。

适合谁用

  • 逢年过节回老家、被一屋子亲戚称呼绕晕的年轻人
  • 刚组建家庭、需要搞清对方亲戚怎么称呼的新人
  • 整理家谱、族谱或亲属关系时需要对准称谓的人
  • 想把中文称谓计算接进自己产品的前端与 Node.js 开发者
  • 对不同地区称呼差异感兴趣、想查证叫法来源的爱好者

主要入口

页面主体是那份中文 README,开头就把”为什么要算称呼”讲明白,随后按六个章节铺开。首屏有项目说明,以及指向网页版和移动版演示的链接,让不想安装的人也能直接试算。往下是”下载 & 安装”,把浏览器引入和 npm 安装两条路都列出来;”使用”摊开选项模式与语句模式的参数和示例;”开发 & 贡献””教程”指向算法实现原理;”关于分歧”和”其他”收拢了地区差异说明与一批在用的站点。整体是开源仓库长文布局,目录、说明、代码与演示串成一条线,想先看效果还是先读源码都能自己挑。

同类对照

  • 和现成的在线称呼查询站比:查询网、有道语文达人等都在用它,那些是封装好的成品、开箱即用;这里给的是背后的开源算法,想接进自己产品才来这里。
  • 和静态称谓对照表比:对照表只能按图索骥、关系一长就翻不过来;它会顺着你给出的亲属链条一路推算,还能反查,适合关系绕了几层、光靠表格查不出来的情况。
  • 和它自己的网页演示版比:网页版和移动版把算法包成输入框、拿来即算;这个仓库则是源码和 npm 包,前者适合临时查一次,后者适合要定制或嵌进项目的人。

数据统计

数据评估

中国亲戚关系计算器浏览人数已经达到5,如你需要查询该站的相关权重信息,可以点击"5118数据""爱站数据""Chinaz数据"进入;以目前的网站数据参考,建议大家请以爱站数据为准,更多网站价值评估因素如:中国亲戚关系计算器的访问速度、搜索引擎收录以及索引量、用户体验等;当然要评估一个站的价值,最主要还是需要根据您自身的需求以及需要,一些确切的数据则需要找中国亲戚关系计算器的站长进行洽谈提供。如该站的IP、PV、跳出率等!

关于中国亲戚关系计算器特别声明

本站跳跳兔导航提供的中国亲戚关系计算器都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由跳跳兔导航实际控制,在2026年11月20日 上午10:33收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,跳跳兔导航不承担任何责任。

相关导航

暂无评论

您必须登录才能参与评论!
立即登录
none
暂无评论...