AI 法律助手

2小时前发布 1 00

AI 法律助手是一个开源的法律文档问答项目,把中文法律文件向量化后存入数据库,先检索相关法条片段,再交给 GPT-3 生成流式回答。它支持自然语言提问、增量更新知识库,并提供一键部署的完整方案,适合想弄懂法律规定的人。

收录时间:
2026-11-19
AI 法律助手AI 法律助手

AI 法律助手是一个法律文档 AI 问答开源项目,主要用来以自然语言查询法律条文,服务于想快速查法条、弄懂法律规定的人。它脱胎于 Supabase 的文档搜索模板,把知识库换成了来自 LawRefBook 项目的中文法律文件,整套代码开源在 GitHub 上,用 Next.js 加 Supabase 搭成:法律文本先被处理成自定义上下文,经向量化后存进 PostgreSQL,提问时再交给 GPT-3 生成回答。和把法条原文直接堆给你看的资料站不同,它走的是先检索、再作答的路子,回答会一句句流式返回;你用日常一句话提问,它给的是依据真实法律片段整理过的说明,省去自己逐条翻找的功夫。
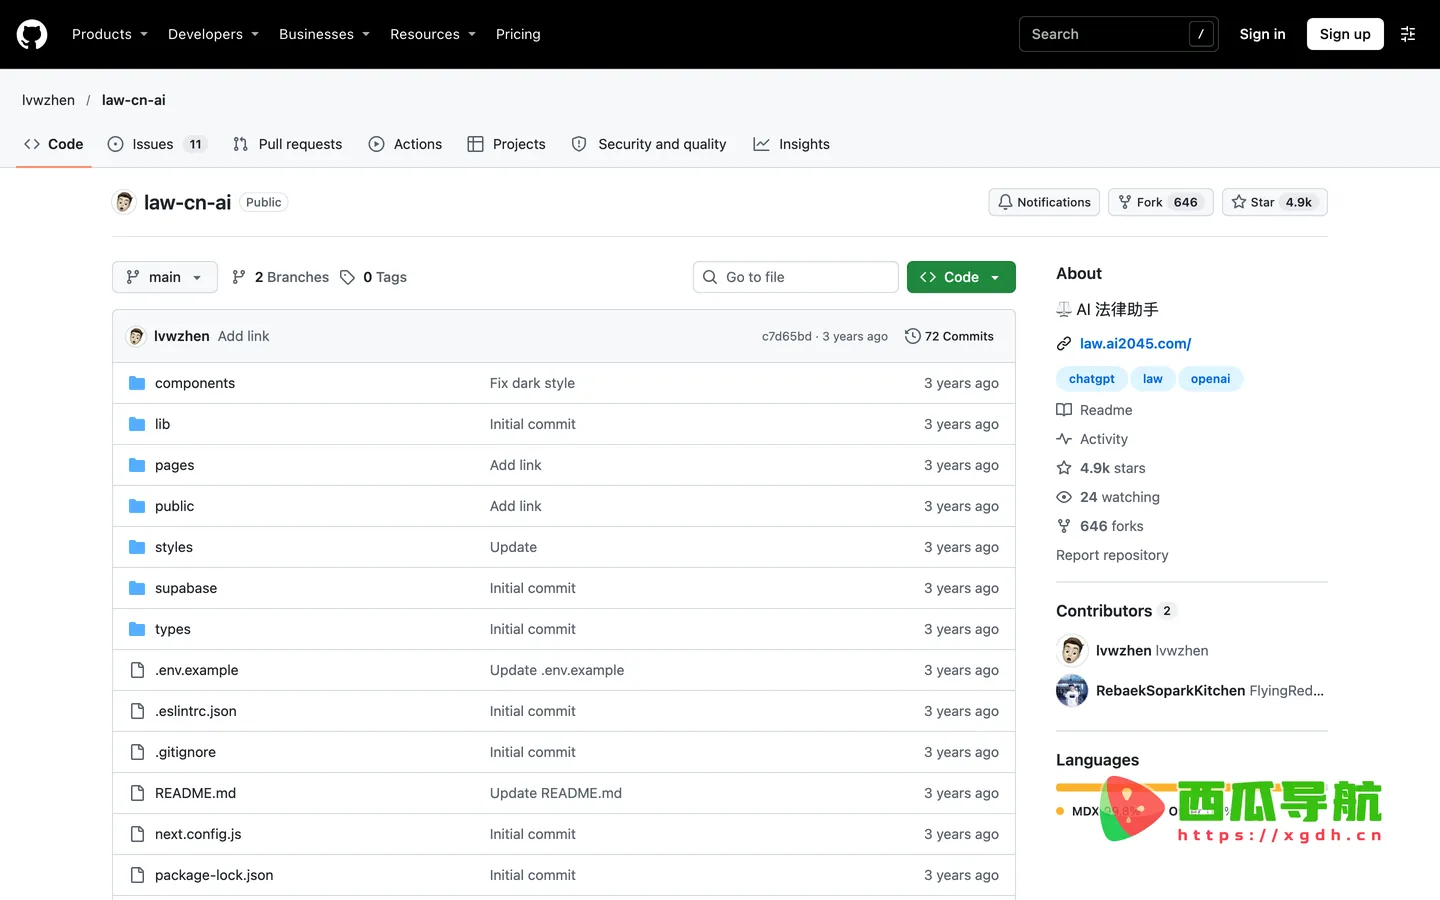
站点名 首页截图

主要功能

  • 自然语言法律问答:这是它的核心用途。页面上的 SearchDialog 组件接收你用日常语言写下的问题,由边缘函数 vector-search 在后台检索,再把命中内容和问题一起送进 GPT-3,回答以流式一段段推回页面,适合问清某条法律究竟该怎么理解。
  • 自建法律文档知识库:知识来源不是模型凭空记忆,而是项目 pages 目录下的 .mdx 文件,对应 LawRefBook 项目整理的中文法律文本。所有文件在构建时被处理成自定义上下文,回答因此有据可依。
  • 向量相似性检索:法律文本经过嵌入处理后存进 PostgreSQL,并启用 pgvector 扩展;提问时先做向量相似性搜索,挑出与问题最相关的片段,再注入自动补全提示,减少答非所问。
  • 增量式嵌入生成:generate-embeddings 脚本为每个文档计算校验和,连同向量一起入库;只有文件内容变了才重新生成嵌入,重复构建不会白跑,对按量计费的接口更省。
  • 一套模板,处处可跑:构建时间完成知识库预处理与向量入库,运行时只管检索与生成;数据库初始化写在 supabase/migrations 里,本地运行会自动套用。

适合谁用

  • 想弄懂某条中国法律、又不愿在长篇法条里逐条翻找的普通用户
  • 需要快速定位相关法律规定、先做初步了解的法律从业者
  • 想把自己的文档做成可问答助手、并看懂整套实现的开发者
  • 关注向量检索、RAG 与流式输出落地方式的开源技术爱好者
  • 希望借现成模板低成本跑通法律问答原型的独立开发者

主要入口

首屏是提问用的问答框,周围是几块说明区。技术细节把做法拆成构建时间与运行时,前者讲知识库预处理与向量入库,后者讲检索和流式回答;本地开发给出从配置环境变量、启动 Supabase 到跑起 Next.js 的路线图,改代码从这里入手。部署说明把这套 starter 放到 Vercel 上、由 Supabase 集成配好环境变量与数据库结构。更多好玩列出智能写作助手、AI 百科全书、Prompt 生成器、AI 翻译专家等相关项目。了解更多指向搭建博客、pgvector 文档和相关视频。

同类对照

  • 和把法条原文按目录罗列的法规资料站相比,它不只给你原文,还会用自然语言把相关内容串起来讲;想快速弄懂某条法律规定的时候选它更省事。
  • 和通用大模型直接聊天相比,它先在自己的法律文档库里检索再作答,回答更贴近真实条文、少凭空发挥;在意答案有没有依据时选它。
  • 和按月订阅的成品法律 AI 工具相比,这是可自部署的开源 starter,代码和数据都在自己手里;想按自己的文档改造或省掉订阅费时选它。

数据统计

数据评估

AI 法律助手浏览人数已经达到1,如你需要查询该站的相关权重信息,可以点击"5118数据""爱站数据""Chinaz数据"进入;以目前的网站数据参考,建议大家请以爱站数据为准,更多网站价值评估因素如:AI 法律助手的访问速度、搜索引擎收录以及索引量、用户体验等;当然要评估一个站的价值,最主要还是需要根据您自身的需求以及需要,一些确切的数据则需要找AI 法律助手的站长进行洽谈提供。如该站的IP、PV、跳出率等!

关于AI 法律助手特别声明

本站跳跳兔导航提供的AI 法律助手都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由跳跳兔导航实际控制,在2026年11月19日 下午10:30收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,跳跳兔导航不承担任何责任。

相关导航

暂无评论

您必须登录才能参与评论!
立即登录
none
暂无评论...