技术学习很少是一口气抵达终点的直线,更多时候它像在陌生城市里找路:先记住几个地标,再慢慢把街巷连成地图。个人技术博客的价值恰恰在这里——它把一个人走过弯路之后留下的笔记按时间铺开,让后来者不必从零开始试探。相比面向大众的教程站点,这类博客往往保留着更真实的取舍痕迹:为什么选这个工具、哪一步踩过坑、方案在真实机器上跑起来是什么样子。读这样的内容,收获的不只是某个命令或配置,更是一套可以迁移的解决问题的方法。本文要介绍的站点就把编程技巧、算法解析、数据分析、机器学习项目与个人成长记录放在同一屋檐下,既适合按主题系统啃读,也适合在遇到具体问题时回来翻找。
逐水寻源是什么?
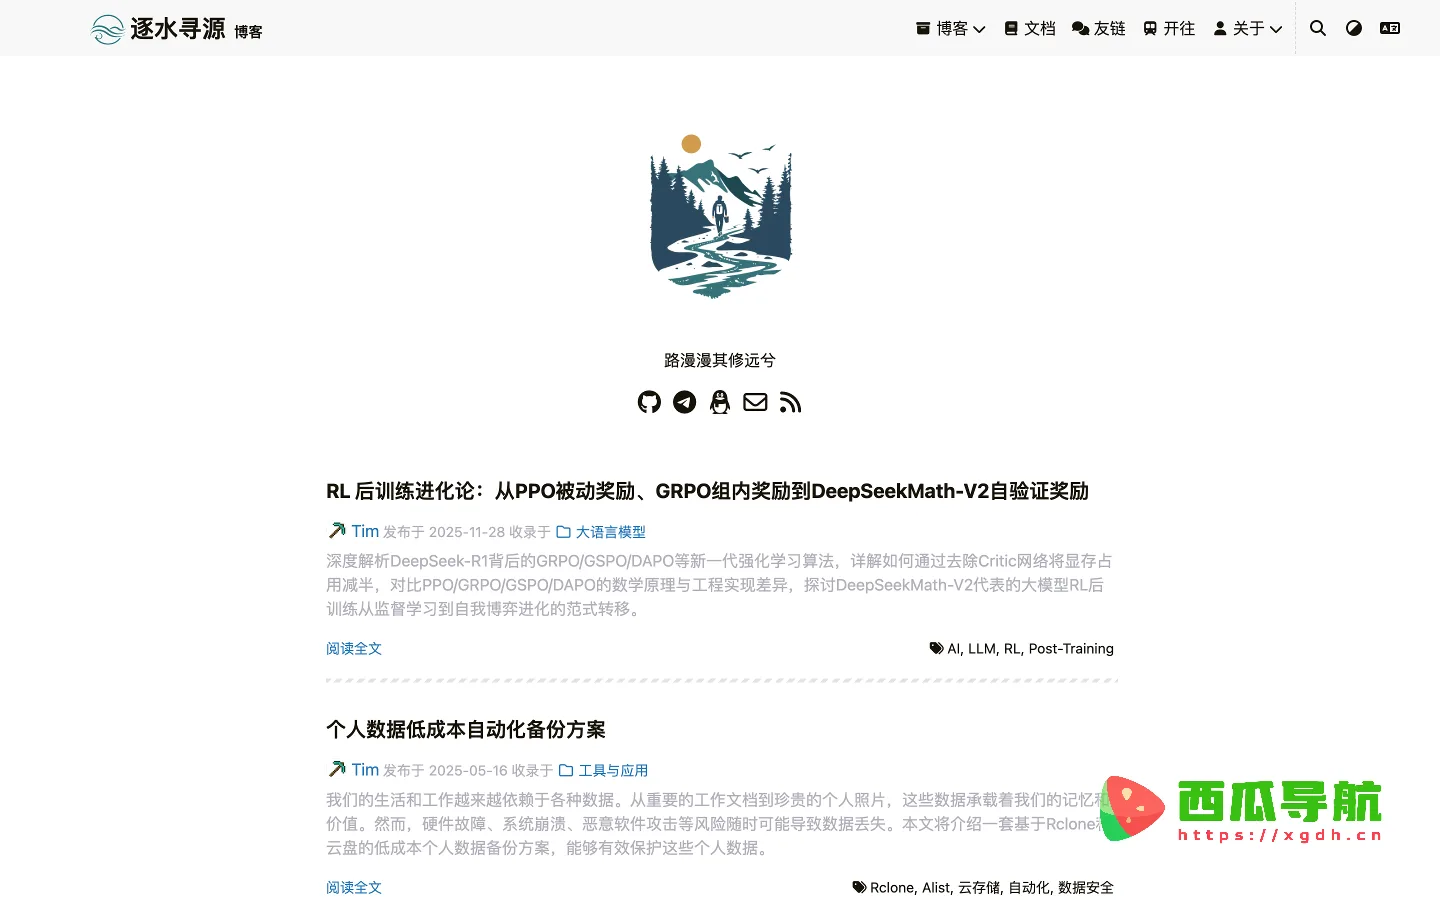
逐水寻源是一个聚焦计算机技术、数据科学与人工智能领域的个人技术博客,主要用来记录博主在学习与实践中积累的编程技巧、算法解析、数据分析与机器学习项目经验,服务于希望沿着技术成长路径持续进阶的读者。站点以博客为主体,向外延展出分类、标签、文档、友链、开往和关于等入口,首页把近期长文标题直接铺开,读者不需要先注册就能判断内容是否对味。从已收录的文章看,它的选题跨度相当大:既有强化学习后训练中奖励机制的演进梳理,也有专家混合模型架构的拆解;既有支持向量机的数学推导,也有个人数据备份、异地组网、家庭网络旁路由这类动手型记录。理论推导与工程实操被放在同一个博客里,说明站方更看重把知识落到可复现的场景,而不是堆砌孤立的概念。
核心功能
- 分类与标签双轨整理——把编程技巧、算法解析、数据分析和机器学习等主题拆成可点开的入口,读者既能按大类系统读,也能用细粒度标签把同类笔记一次找齐。
- 文档入口沉淀体系化内容——相对于博客的阶段性记录,文档页更适合承载长期维护的知识,适合用来查漏补缺和建立框架。
- 友链与开往的站点联动——把同方向的个人站点串成阅读网络,读完一篇长文后可以顺着链接继续发现更多独立博客。
- 多语言导航切换——菜单里提供 French、日本语、English 等语言选项,降低非中文读者的阅读门槛,也方便对照专业术语。
- 长文专题深度拆解——从强化学习奖励机制的演进到专家混合模型架构对比,文章倾向把背景、推导与结论完整铺开,适合愿意慢读的读者。
- 实操记录贴近真实环境——备份方案、异地组网和家庭网络旁路由等内容都带着具体场景,读者可以照着思路在自己的机器上复现与调整。
- 站点自述与阅读路径——关于和关于博客页面交代站点定位,让新访客快速判断这里是否值得长期关注。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 计算机专业学生 | 在课堂之外找一份把算法与数据结构讲得通俗的中文笔记,配合示例理解课堂概念 | ★★★★★ |
| 数据分析从业者 | 翻阅数据科学教程与机器学习项目记录,借鉴从数据处理到建模的思路 | ★★★★☆ |
| 后端与运维工程师 | 参考容器、旁路由、异地组网等实操文章,解决家庭或实验室网络配置问题 | ★★★★★ |
| 关注大模型的学习者 | 跟踪强化学习后训练、专家混合模型等专题长文,梳理技术演进脉络 | ★★★★☆ |
| 独立博客爱好者 | 通过友链与开往入口发现同类站点,顺手对照多语言导航的写法 | ★★★☆☆ |
操作指南
- 在导航页找到本站条目,点击 立即使用,再点开 zair.top 进入首页。首屏是近期文章的标题列表,先整体扫一遍,确认更新方向是否贴合自己当前的学习目标。
- 进入后走顶部导航的博客入口查看完整列表,按时间从新到旧阅读;遇到标题很长的专题,先读开头几段判断深度,再决定是否完整展开,避免在信息密度高的页面里迷路。
- 想系统啃一个主题时切到分类页,把编程技巧、算法解析、数据分析、机器学习等主题逐项展开;同一主题下的文章往往按难度递进排列,顺着读比跳着读更容易建立整体框架。
- 用标签页做横向检索。标签比分类更细,适合把散落在不同分类里、却围绕同一工具的笔记串起来,例如把网络配置相关的几篇一次读完,省去反复返回列表的动作。
- 需要成体系资料时走文档入口;文档偏长期维护的知识沉淀,博客偏阶段性记录,两者搭配使用能让查漏补缺更有方向。
- 通过友链和开往入口顺藤摸瓜,发现同方向的个人站点;看到语言菜单里有 French、日本语、English 等选项时,也可以切换到对应版本对照阅读,顺手积累专业词汇的英文表达。
- 最后到关于与关于博客页了解站点的定位与更新倾向;如果某篇文章解决了你的问题,记下它的标题和所属分类,方便日后按图索骥,从导航页再次进入时直接定位。
支持平台
从可核验的信息看,站点以 Web 形态提供服务,通过浏览器打开即可阅读,没有需要安装的客户端;抓取信号中出现 Linux,说明内容涉及的实操环境明显偏向 Linux 生态,但这描述的是文章里的技术场景,并不代表访问本身限定系统。导航里还列出 French、日本语、English 等语言选项,属于站点层面的界面能力,而不是独立平台。至于手机客户端、微信小程序或浏览器插件,站方没有明确列出,目前能确认的只有网页版本。
产品定价
站方未公开价格信息,以站内为准。从抓取信号看,页面既没有登录入口,也没有任何价格标记,内容以开放阅读的方式呈现,读者不必先注册再判断值不值得读。如果后续出现付费专栏、打赏或其他形式的收费安排,同样以站内实际展示为准;本文不做推测,也不替站方给出任何价格承诺。
常见问题
Q:这是一个需要注册登录或付费的站点吗?
从抓取到的信号看,页面里没有登录入口,也没有价格标记,首页内容可以直接阅读。站方未公开价格信息,以站内为准;即便后续出现调整,也以页面实际展示为准,不必提前做付费预期。
Q:内容主要覆盖哪些方向?
两条线比较清晰:一条是理论与算法,比如强化学习后训练中从被动奖励到组内奖励再到自验证奖励的演进、专家混合模型的架构对比、支持向量机的优化推导;另一条是动手实践,比如个人数据的低成本自动化备份、自建 Tailscale 中转节点的异地组网,以及在闲置设备上用容器跑旁路由的家庭网络配置。两条线都尽量交代来龙去脉,而不是只给结论。
Q:看不懂中文还有其他语言版本吗?
导航里除了博客、分类、标签、文档、友链、开往、关于和关于博客这些常规入口,还列出了 French、日本语、English 三种语言选项,说明站点考虑了非中文读者的阅读习惯。不过正文主要由中文写成,语言切换具体覆盖到哪些页面,建议进入后以实际菜单为准。
开发者小结
把这样一座个人技术博客收录进来,看重的是它在深度与可发现性之间取得的平衡:分类、标签、文档、友链和开往让长文不至于沉在列表底部,多语言菜单又给非中文读者留了一条入口。它的边界同样清楚——内容高度依赖博主个人的更新节奏,更新频率并不稳定;强实操类文章自带环境前提,读者需要按自己的机器和网络条件做调整;页面信息密度偏高,不适合用来快速查询一个词条的答案。它更适合愿意按顺序读长文、愿意动手复现的读者,而不是只想立刻拿到结论的人。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章


暂无评论...