把散落在各家厂商文档里的模型信息整理成一份可检索的清单,听起来简单,做起来却繁琐。每家实验室的命名习惯不同、价格结构不同、能力标注的口径也不同,想把几十上百个模型的规格、定价与支持特性摆在同一张表里对比,往往要翻遍十余个页面。Models.dev 正是在这种重复劳动里被催生出来的开源项目,它把 AI 模型的规格、价格与能力收敛进一份社区维护的数据集,并对外提供接口供程序直接读取。对于要做技术选型、在应用里接入多家模型,或单纯想搞清楚某个模型能力边界的人来说,它省掉的是一遍遍抄表格的时间。下面按是什么、能做什么、怎么用、适合谁这几个角度,把这份数据项目的实际价值拆开讲清楚。
Models.dev是什么?
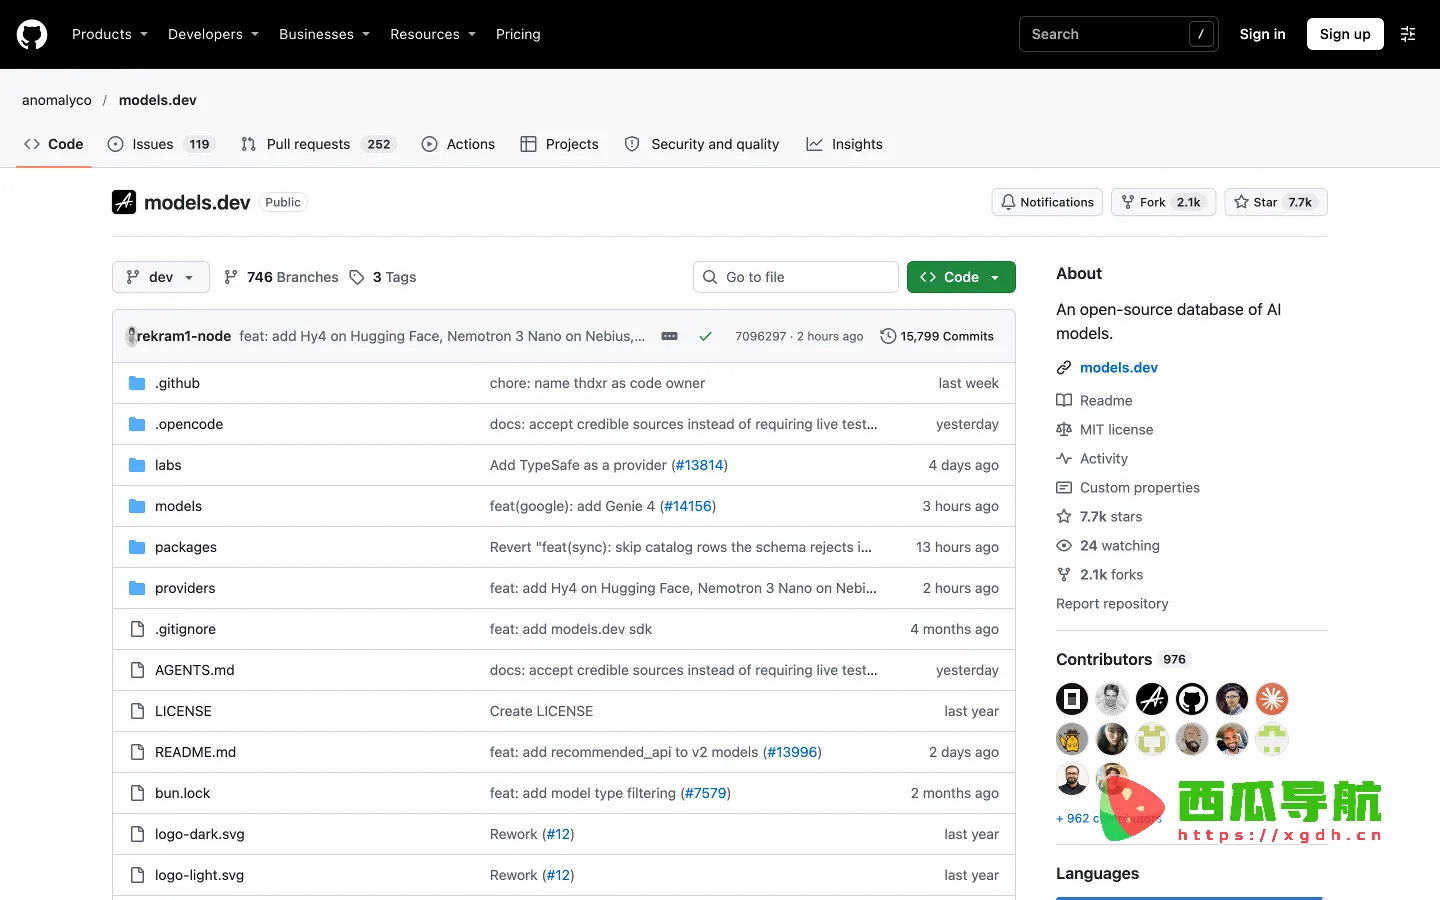
Models.dev是一个由社区共同维护的开源 AI 模型规格数据库,主要用来汇总各类模型的规格参数、定价信息与能力特性并提供统一查询接口,服务于需要对比、选型并接入多家模型的人。它把分散在不同厂商文档里的数据收拢成结构一致的条目,每个模型都带有能力开关、成本明细和发布时间等字段,省去人工逐页摘录的功夫。项目本身也是 opencode 内部在用的数据底座,意味着它不是一份摆着看的静态清单,而是被真实产品持续消费、随模型迭代不断更新的活数据。
核心功能
- 统一模型数据库——把分散在各家厂商文档里的模型规格、价格与能力收拢成结构一致的条目,省去逐页摘录的时间。
- 开放 API 查询——通过接口直接读取模型数据,让程序能自动拿到规格、定价与能力信息,不用手工维护表格。
- 模型类型筛选——默认目录会省略专门用途的模型,可用逗号分隔的类型参数按需过滤,或用 all 拿到完整清单,目前专门类型只有 decision。
- 按模型 ID 定位——用 AI SDK 使用的模型 ID 做精确查找,命中后即可读到该模型的能力开关与成本明细。
- 厂商无关元数据——单独提供与托管方无关的模型事实,方便只关心模型本身属性的调研场景。
- 供应商 Logo 资源——以 SVG 文件形式提供各家供应商标识,用 Provider ID 替换路径中的占位符即可取用,缺失时回落到默认图标。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 应用开发者 | 接入多家模型时,用统一数据比对价格与能力,减少翻文档的时间 | ★★★★★ |
| 技术选型负责人 | 为团队挑选合适模型,按能力开关和成本明细做横向筛选 | ★★★★☆ |
| 数据研究人员 | 查询模型发布时间、知识截止与权重开放情况,辅助调研 | ★★★★☆ |
| 开源贡献者 | 参与维护数据集,补齐或修正模型的规格与价格字段 | ★★★★☆ |
| 工具链集成方 | 通过接口把模型数据接入自有平台,配合 Logo 资源做展示 | ★★★★☆ |
操作指南
- 访问网站入口:在浏览器打开 Models.dev,把页面上的 立即使用 视作开始查询的快捷入口,先整体浏览一遍它收录了哪些供应商与模型,确认覆盖范围符合自己的需要。
- 明确查询目标:想查某家供应商,就先看供应商条目里的 name、npm、env、doc 与 api 几个字段,弄清认证所需的环境变量与 OpenAI 兼容的接口地址。
- 按模型 ID 定位:用 AI SDK 使用的 Model ID 做检索,命中后阅读模型字段,包括能力开关(toolcall、reasoning、structuredoutput、temperature 等)与成本明细(cost.input、cost.output)。
- 处理专门类型:默认目录会省略专门用途的模型,需要完整清单时传类型参数或 all;目前专门类型只有 decision,按需过滤即可,experimental v2 目录默认收录全部类型。
- 调用接口自动化:通过 API 读取 models.json、catalog.json 或 model-schema.json,把数据接入自己的脚本或应用,避免手工搬运带来的滞后与误差。
- 取用供应商图标:需要展示标识时,用 Provider ID 替换 Logo 路径中的占位符拿到 SVG;没有对应图标会自动回落到默认图,省去自己找素材的麻烦。
- 参与数据维护:发现字段缺失或过时,按仓库约定提交更正,让数据集随模型迭代保持新鲜,也让自己的使用经验反哺社区。
支持平台
从可见信息看,Models.dev 主要通过 Web 网站对外展示,并提供可编程访问的 API 接口,数据以 JSON 形式(models.json、catalog.json、model-schema.json)对外提供。它也作为数据底座被 opencode 这类客户端工具在内部使用,字段中的 npm 指向 AI SDK 包名,便于在代码项目里集成。站方没有明确列出独立 App、小程序或浏览器插件等形态,桌面与移动端的原生应用情况未作说明。
产品定价
站方未公开价格信息,以站内为准。需要区分的是,数据库里记录的 cost.input、cost.output、cost.reasoning 等字段是各个模型自身的调用成本数据,按每百万 token 计价,用于对比不同模型的价格差异;这不是 Models.dev 向用户收取的费用。至于站点本身是否收费、是否提供付费套餐,现有信息里没有说明,如有需要请以站内公告为准。
常见问题
Q:Models.dev 的数据适合直接当作选型依据吗?
它提供的是结构一致的规格、价格与能力字段,适合做横向对比和初筛,但模型能力会随版本更新而变化,字段里的 knowledge、lastupdated 等时间信息需要结合实际情况判断,关键决策仍建议回到厂商文档复核,把它当作线索而非终稿。
Q:默认目录里为什么找不到某些模型类型?
为了让默认视图更聚焦,专门用途的模型类型默认被省略,目前这类专门类型只有 decision。需要完整清单时,可以用类型参数筛选或传 all 拿到全部;experimental v2 目录默认包含所有类型,过滤方式一致,只是部分条目需要显式包含才会出现。
Q:把数据集接进自己的应用要注意什么?
优先通过 API 读取 JSON 数据,而不是手工抓取页面;按 Model ID 做精确查找能减少歧义。若同时需要供应商端点与厂商无关的模型元数据,要留意两类数据各自的用途。另外部分条目依赖客户端管理的 OAuth 认证,接入前需确认自己的环境支持相应设置。
开发者小结
对需要频繁在多模型之间做对比的开发者来说,Models.dev 的价值在于把碎片化的规格与价格信息变成可编程读取的稳定结构,省下重复搬运表格的精力;它的边界同样明显,数据依赖社区维护,时效与完整度会随贡献情况波动,专门类型默认隐藏也意味着你需要理解类型参数才能拿到全量。它更适合作为选型与集成的起点,而非权威事实来源,关键结论仍需回到厂商文档交叉验证。若日常工作涉及多家模型的接入与成本核算,这份数据集值得放进工具箱;若只跟踪单一模型,直接读官方文档反而更省事。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...