面对一个具体问题,很多人习惯打开搜索引擎,在成排的链接里逐条点开、快速扫读,再把零散信息在脑子里拼成答案。这个过程费时,而且很难说清答案究竟来自哪里。Turbo Seek 把这段流程改写成一条更短的链路:它先替你去检索网络,抓取相关页面的正文作为上下文,再交给大语言模型归纳成一段可以直接读的回答,并把引用一并带上。它是一个开源项目,代码公开,任何人都能读懂每一步是怎么串起来的,也能按自己的需要改。对想弄明白检索增强回答到底如何落地的人来说,它更像一份可以跑起来的样本,而不是一个只能点按钮的黑箱。下面按是什么、核心功能、使用场景、操作指南、支持平台、产品定价、常见问题和开发者小结八个部分,把这个项目讲清楚,方便你判断要不要花时间把它跑一遍。
Turbo Seek是什么?
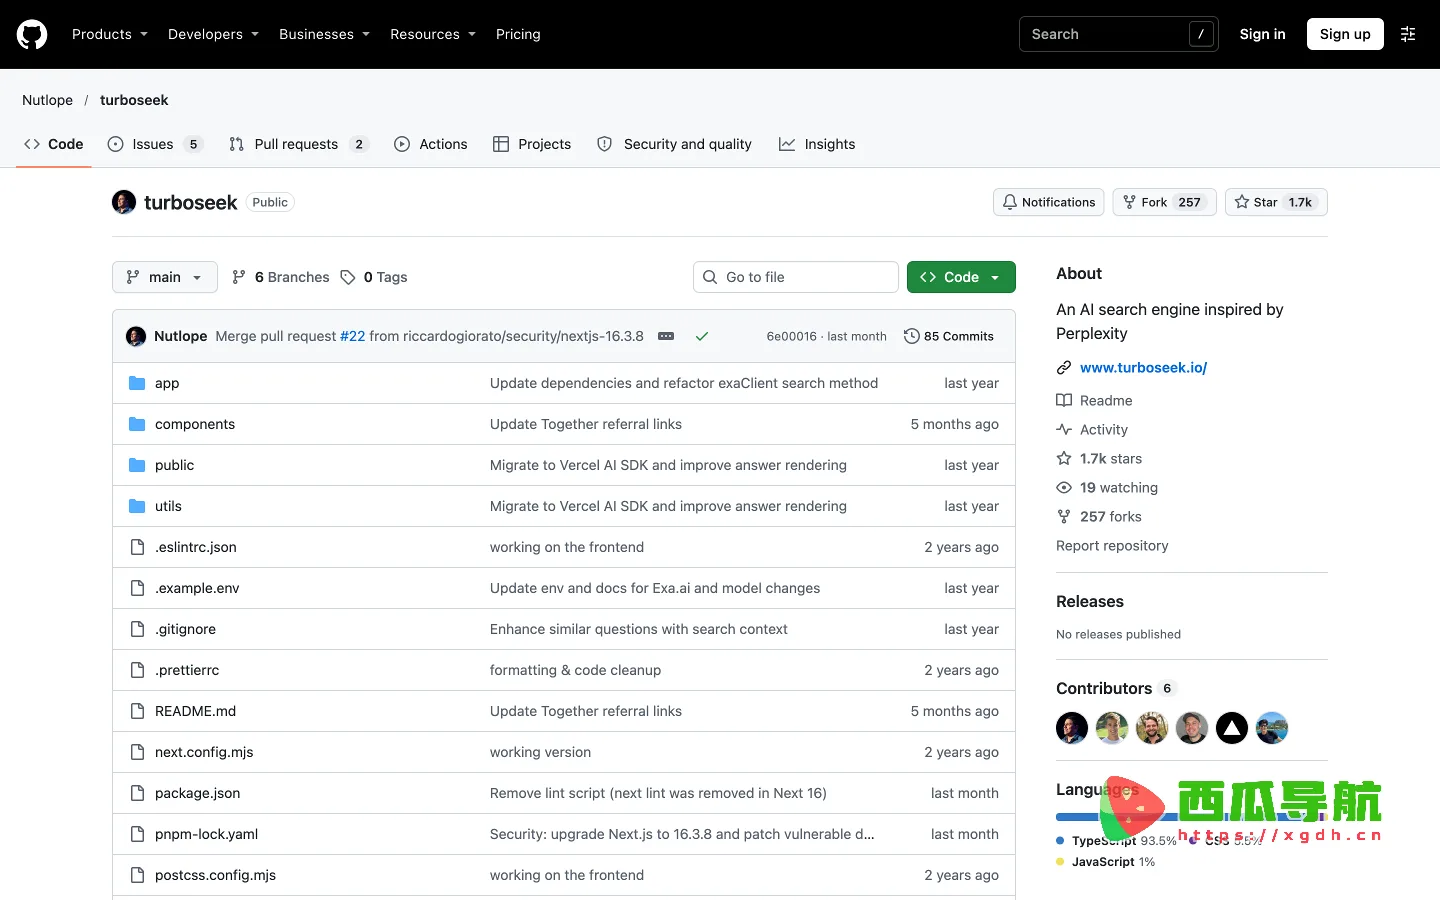
Turbo Seek是一个开源的 AI 搜索引擎,主要用来把网络检索到的资料整理成带引用的回答,服务于希望看清搜索结果如何被模型消化、并愿意自己动手搭建实验环境的人。整个项目由 Together AI 提供推理支持,界面部分用 Next.js 的 app router 配合 Tailwind 完成。它的定位不是替代日常搜索,而是把检索、抓取、归纳这条链路摊开给你看:从接收问题、拿到搜索结果,到把页面正文变成上下文,再到流式吐出回答,每一步都能在代码里找到对应位置。因为项目开源,你可以顺着 README 里的工作流逐段对照,理解一个带引用的回答是怎么一步步生成的。
核心功能
- 问题接收与检索——接收用户提出的问题,先向搜索接口请求前六条结果并展示出来,让你看到一个答案背后的素材来源。
- 正文抓取与上下文组装——把搜索返回的六条链接逐一抓取文本,整理成模型可读的上下文,省去手工复制粘贴的环节。
- 流式回答输出——把问题与上下文一起交给模型推理,并将生成过程持续回传,读起来像在对话,而不是等一整段文字突然出现。
- 相关追问生成——再调用另一个模型给出三个可继续追问的问题,方便顺着一条线索往下挖。
- 引用对应——目标是让回答中的说法能逐条对上来源,并在界面里编号展示,便于核对每一句的依据。
- 可观测与统计接入——技术栈里包含用于观测调用情况的工具与用于站点统计的工具,方便看清请求与访问的整体状况。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 前端与全栈学习者 | 想看一个 Next.js 项目怎样把搜索、抓取和模型串起来,照着说明把流程跑通 | ★★★★★ |
| RAG 方向研究者 | 需要一份可改动的最小样本,验证检索上下文如何进入提示词并影响回答 | ★★★★☆ |
| 独立开发者 | 打算做一个带出处的问答工具,先借用现成结构,再替换自己的模型与搜索源 | ★★★★☆ |
| 教学内容设计者 | 需要一个能演示流式回答与追问生成的例子,讲清检索增强的完整流程 | ★★★☆☆ |
| 只想日常搜索的用户 | 希望开箱即用的成品搜索服务,不愿花时间配置密钥与本地环境 | ★★☆☆☆ |
操作指南
- 先打开 Turbo Seek 项目仓库,把代码取到本地,可以选择 fork 一份再克隆,这样后续改动会留下自己的版本记录。
- 准备好几个必需的服务账号:一个用于大模型推理的平台账号,一个用于搜索结果的接口账号,以及一个用于观测调用情况的账号。搜索这一步按事实说明可以走 SERP 接口或 Azure 的搜索服务,按你手头已有的资源选其一即可。
- 参照仓库里的示例环境变量文件建立自己的配置文件,把上一步拿到的密钥逐项填进去,注意不要把填好的文件提交到公开仓库。
- 在项目目录执行依赖安装命令,等待依赖下载完成。首次运行拉取的包较多,花几分钟属正常情况。
- 启动本地开发服务,界面起来后在输入框提一个问题,观察它怎样先给出检索结果,再把回答逐字流式呈现出来。
- 回答出现后,留意文末的相关追问,点其中一个可以继续深入;同时对照正文里的引用,看每条说法对应哪个来源页面。
- 想改造成自己的版本,可以先从替换模型或搜索源入手,再逐步调整提示词与上下文的组装方式。准备动手时点开 立即使用 进入项目页面,按上面的顺序逐项配置。
支持平台
从技术栈看,项目采用 Next.js 的 app router 构建,属于通过浏览器访问的 Web 应用;除此之外,站方没有明确列出客户端、小程序或浏览器插件等其他形态。
产品定价
站方未公开价格信息,以站内为准。项目本身以开源形式提供,代码可以自行获取与修改;本地运行前需要准备模型推理、搜索接口与观测服务的账号,相关条款以各自服务方的说明为准。
常见问题
Q:Turbo Seek 和普通搜索引擎有什么不同?
普通搜索引擎给出一串链接,由你自己点开筛选;Turbo Seek 会把检索到的页面正文交给模型,直接整理成一段带引用的回答,并附上可以继续追问的问题。它的代码公开,你能看清每一步是怎么实现的。
Q:使用 Turbo Seek 需要做哪些准备?
按克隆与运行一节,先取得项目代码,再准备模型推理平台、搜索接口和观测服务的账号,然后参照示例环境变量文件填入密钥,安装依赖后启动本地服务即可开始提问。
Q:可以把它改成自己的搜索工具吗?
可以。项目是开源的,说明里列出了后续想做的方向,例如更简单的流式输出、加入缓存与限速、分享回答、移动端自动滚动等。你可以沿着这些方向替换模型或搜索源,按自己的场景调整。
开发者小结
Turbo Seek 的价值在于把一条检索增强回答的链路做得足够小、足够透明:从搜索、抓取到流式回答和追问,每一步都对应到可读的代码,对想学原理或做原型验证的人来说,比直接用成品服务更有收获。它的边界也很清楚——项目带有明显的实验性质,说明里还留着不少待办,例如引用编号的完善、缓存与限速、分享能力等;回答质量依赖你接入的模型与搜索源,运行环境需要自己配置密钥并承担相应成本。如果你要的是稳定、免配置的日常搜索,它并不是省事的选择;如果你愿意动手,把它当作一份能跑的教学样本来拆解,回报会更实在。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...