监控一个模型接口通不通,看上去只是发个请求看一眼返回码的事。真正跑过中转服务的人知道,麻烦往往出在返回码之后:网关活着、HTTP 也回了 200,模型那一侧却在空转、被限流,或者吐回一段没有意义的占位文本,用户拿到的仍然是失败。RelayPulse 想补的就是这道缝——它不满足于确认端口有没有开,而是真的花掉一点 Token 去问模型一句话,再检查这句话像不像正常回答,确认模型确实开口了,才把这一次记成可用。判断逻辑写在仓库里公开可查,数据落在自己部署的数据库里,配置和密钥不出本机,可以摆在一台小机器上长期巡检,也能跟着容器一起扩成多副本。
RelayPulse是什么?
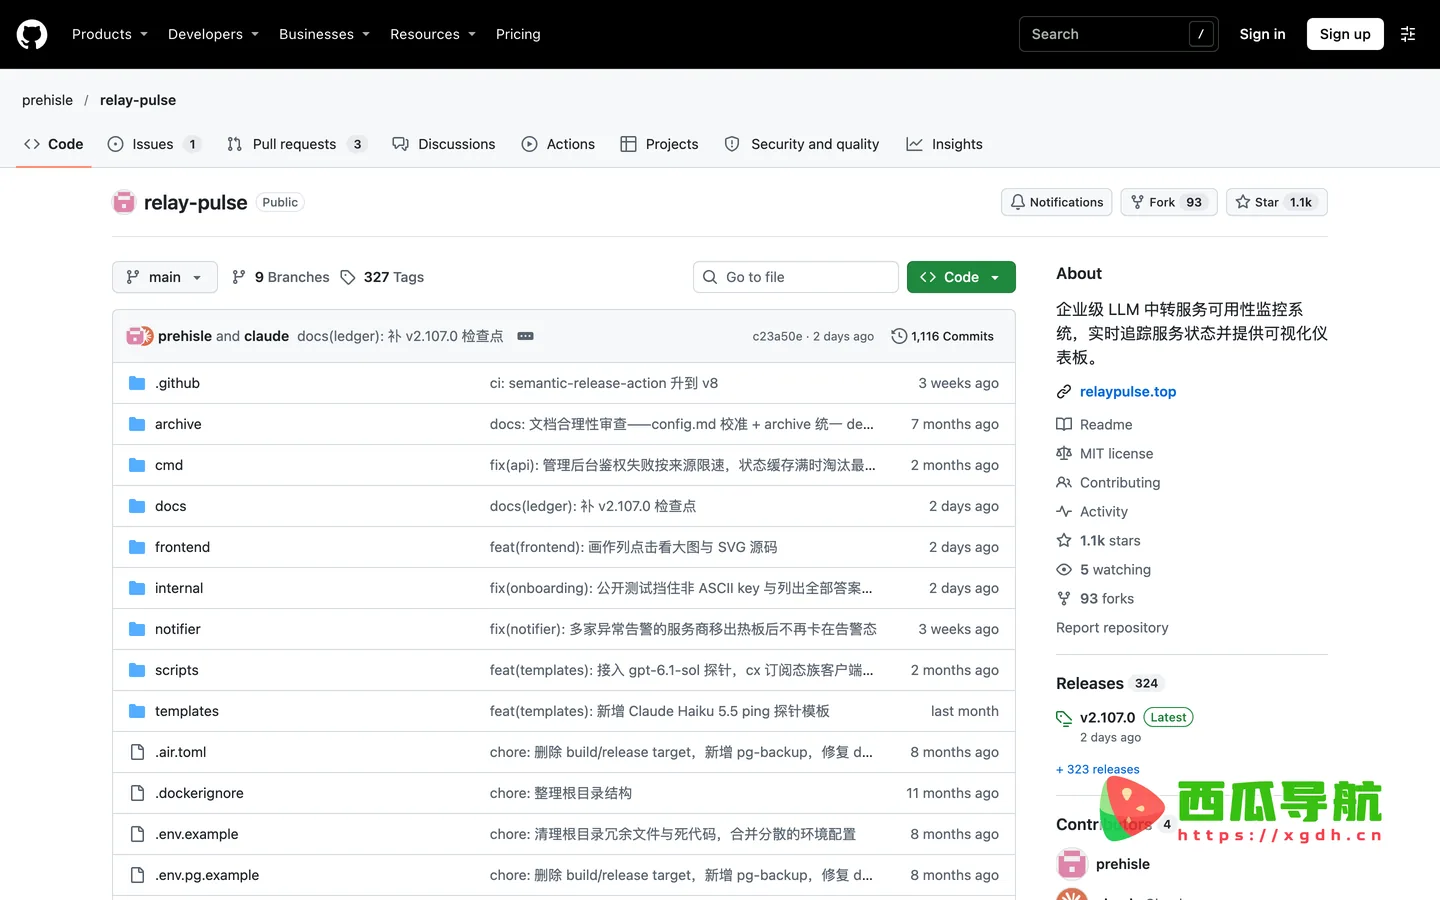
RelayPulse 是一个开源的 LLM 中转服务可用性监控工具,主要用来按固定间隔向配置好的模型接口发起真实请求并校验返回内容,从而判断这条调用链路此刻是否真的能用,服务于自建或采购了模型中转、需要持续确认 SLA 的运维与开发者。它把传统探活工具只确认连通性的做法往前推了一步:探测请求会真实消耗 Token,只有模型正常返回了可通过校验的内容,这一次才算通过,网关通了但模型没答的情况会被如实记成失败。
监控项、密钥和探测间隔都写在一份本地配置文件里,进程自己感知文件变化并热加载,不必为了加一个端点停一次服务。探测结果按 24 小时、7 天、30 天三个窗口聚合成可用性矩阵,和延迟、错误率放在一起看,供应商之间的差距比单看一条曲线清楚得多。存储可以是单机的一份 SQLite 文件,零配置起步;也可以换成 PostgreSQL,让多个副本写同一份数据。部署形态是一个精简的容器镜像,本地开发则按开发者指南直接跑源码。
核心功能
- 真实 API 探测——每次探测都真的花 Token 去请求模型并检查回包内容,把网关通了但模型没答的情况挡在可用率之外。
- 可用性热力图——按 24 小时、7 天、30 天三个窗口铺开可用率矩阵,哪个时段、哪个供应商掉链子,扫一眼就能定位。
- 配置热加载——基于 fsnotify 监听配置文件,新增监控项、调整探测间隔都只是保存文件的事,不用重启进程。
- 多存储后端——单机用 SQLite 零配置起步,多副本或 Kubernetes 环境换成 PostgreSQL 做共享存储。
- 云原生部署——提供精简的容器镜像,容器化拉起之后直接靠多副本横向扩容。
- 延迟与错误率统计——每次探测的耗时和失败原因都被记录,多个端点可以放在同一张表里横向比对。
- 供应商排名——排名依据最近 24 小时的真实可用率,而不是靠人工印象或者某一次的偶然结果。
- 本地数据留存——配置、密钥与探测记录都留在自己部署的环境里,不往外部服务回传。
使用场景
不同角色用它的方式差别不小,下面这张表按常见的几种用法归了一下。
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 自建中转的运维 | 手上有几条自己维护的模型链路,需要一份持续记录来确认 SLA 有没有掉,出问题能翻回具体时段 | ★★★★★ |
| 采购中转的团队 | 付了钱就要验收,用真实探测把供应商承诺的可用率和实际表现对上账 | ★★★★★ |
| 做多云比选的架构师 | 同一批提示词打向不同厂商,把延迟和错误率并排看,选型不再只靠报价单 | ★★★★☆ |
| 依赖外部 API 的产品团队 | 自己的服务卡住时,先确认是上游模型挂了还是本方逻辑出错,少走冤枉路 | ★★★★☆ |
| 个人开发者 | 手里一两个小项目,想低成本盯着接口,单机 SQLite 加容器就够 | ★★★☆☆ |
| 教学与实验环境 | 需要一份可复现的可用性数据来讲链路质量,配置和结果都能自己掌握 | ★★★☆☆ |
操作指南
- 先想清楚要盯哪几条链路。配置文件里每一个监控项对应一个中转站或一个模型端点,写上地址、密钥、模型名和探测间隔。默认是每分钟一次,端点多了可以适当放宽,免得同一时刻把请求堆在一起。
- 决定存储。单机自用直接留 SQLite,进程起来就有一份本地库文件,不必另外装数据库;准备跑多副本或者放进 Kubernetes,就把后端切成 PostgreSQL,让几个实例写同一份数据。
- 拉起服务。官方提供精简的容器镜像,一条 docker run 或者一份 compose 文件把配置目录挂进去就能跑;本地调试按开发者指南直接从源码起。
- 打开浏览器进入面板,在总览里点 立即使用,就能看到刚加进去的监控项开始出第一批结果。手上还没有部署环境的话,可以先到 RelayPulse 的在线演示,看一份已经跑了一段时间的矩阵长什么样,再决定自己要配多少条。
- 盯矩阵而不是盯单条曲线。24 小时窗口适合排查今天早上的抖动,7 天和 30 天窗口用来判断某个供应商是不是长期不稳,颜色断在哪一格,问题就出在那段时间。
- 改配置不用重启。新增端点、改间隔、换密钥,保存文件后进程会自己重新加载,面板上的监控项随之更新。
- 需要对外供数时再打开接口。面板背后的 HTTP 接口可以按时间窗口取聚合结果,接到自己的告警或者看板上;采样尽量按固定间隔来,原因见下面的常见问题。
支持平台
从仓库和文档能看到的主要入口是浏览器里的 Web 面板:服务起来之后用浏览器访问,看矩阵、看延迟、看排名都在这一层完成,不需要额外装桌面客户端。部署侧给的是精简的容器镜像,Docker 和 Kubernetes 都能跑,横向扩容靠多副本加共享存储。数据后端有两个选择,SQLite 面向单机,PostgreSQL 面向多副本。手机客户端、小程序、浏览器插件这一类,站方没有明确列出,实际以站内说明为准。
产品定价
站方未公开价格信息,以站内为准。
从项目自己的说明看,它走的是开源加自托管的路线,没有订阅档位,主要成本落在探测消耗的 Token 上:每次探测把输出上限压到 1 个 Token 左右,一次大约 20 个输入 Token 加 1 个输出 Token,按默认每分钟一次的频率,单个服务一天约三万 Token。这个量级换算成常见的模型单价通常很小,链路越多、间隔越密,成本越高,把间隔从一分钟放到五分钟就能省下大半。至于赞助档位和对应权益,仓库里另有单独的说明与协议文档,不影响正常使用。
常见问题
Q:它和 Uptime Kuma 这类探活工具有什么区别?
这类工具检查的是 HTTP 连通性,端口开着、状态码是 200 就算在线。可在中转场景里,200 之后跟着一段空响应或者报错文本是常事,连通性正常不等于模型能答话。RelayPulse 的做法是让探测请求真的消耗 Token 去问模型,再校验回包内容,模型没开口就不算可用。代价是每次探测有极小量的 Token 支出,换来的是可用率数字更接近用户体感。
Q:每分钟探一次,一天下来会不会很费 Token?
按项目给出的数字,每次探测大约 20 个输入 Token 加 1 个输出 Token,输出上限压到 1 个 Token,默认每分钟一次,一个服务一天累计约三万 Token。这个量级在多数模型上换算成钱都很轻,端点数量和探测频率是主要会推高它的变量。链路多的时候把间隔放宽到几分钟,成本会成比例下降,而可用率的趋势基本不受影响。
Q:为什么热力图的格子边界看起来会飘?
因为每次请求的时间基准都不一样,落进时间桶的位置自然会有细微偏移,格子边界也就跟着稍微移动。这不是数据错,只是分桶方式带来的正常现象。要做稳定的数据对接,建议按固定间隔采样,让相邻两次探测落在可预期的位置上。
开发者小结
RelayPulse 的取舍很清楚:它放弃了廉价的心跳式探活,改用真实消耗 Token 的请求去换可信度,代价是一点点费用和对密钥的依赖;它也放弃了开箱即用的云服务形态,把配置、数据和部署都交回使用者手里,好处是没有外部依赖、数据不出门,代价是得自己维护一台机器和一个数据库。链路数量不多、对可用率数字有要求、又愿意花半小时把容器跑起来的人,用它很合适;只想确认端口有没有开的场景,传统探活工具更省事。真正需要留意的是探测频率和采样口径,配错了矩阵会好看但不可信。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...