把成百上千份中文法律文件变成能直接提问、能给出文本依据的对话式知识库,是很多法律从业者和独立开发者都动过心的方向。law-cn-ai 就是这个思路的一次开源落地:它把开源法律文本当作知识底座,用向量检索先找出与问题最相关的段落,再交给大模型组织成自然语言回答。整个项目从一个现成的文档搜索模板改造而来,代码量不大,却把构建时间与运行时两条链路拆得清清楚楚。对想理解检索增强问答怎么搭、又关心中文法律语料怎么接入的人来说,它是一份可以照着读、照着跑的样本。本文只依据项目公开页面与说明文档,把它的能力、部署方式和适用边界逐项梳理清楚。
AI 法律助手是什么?
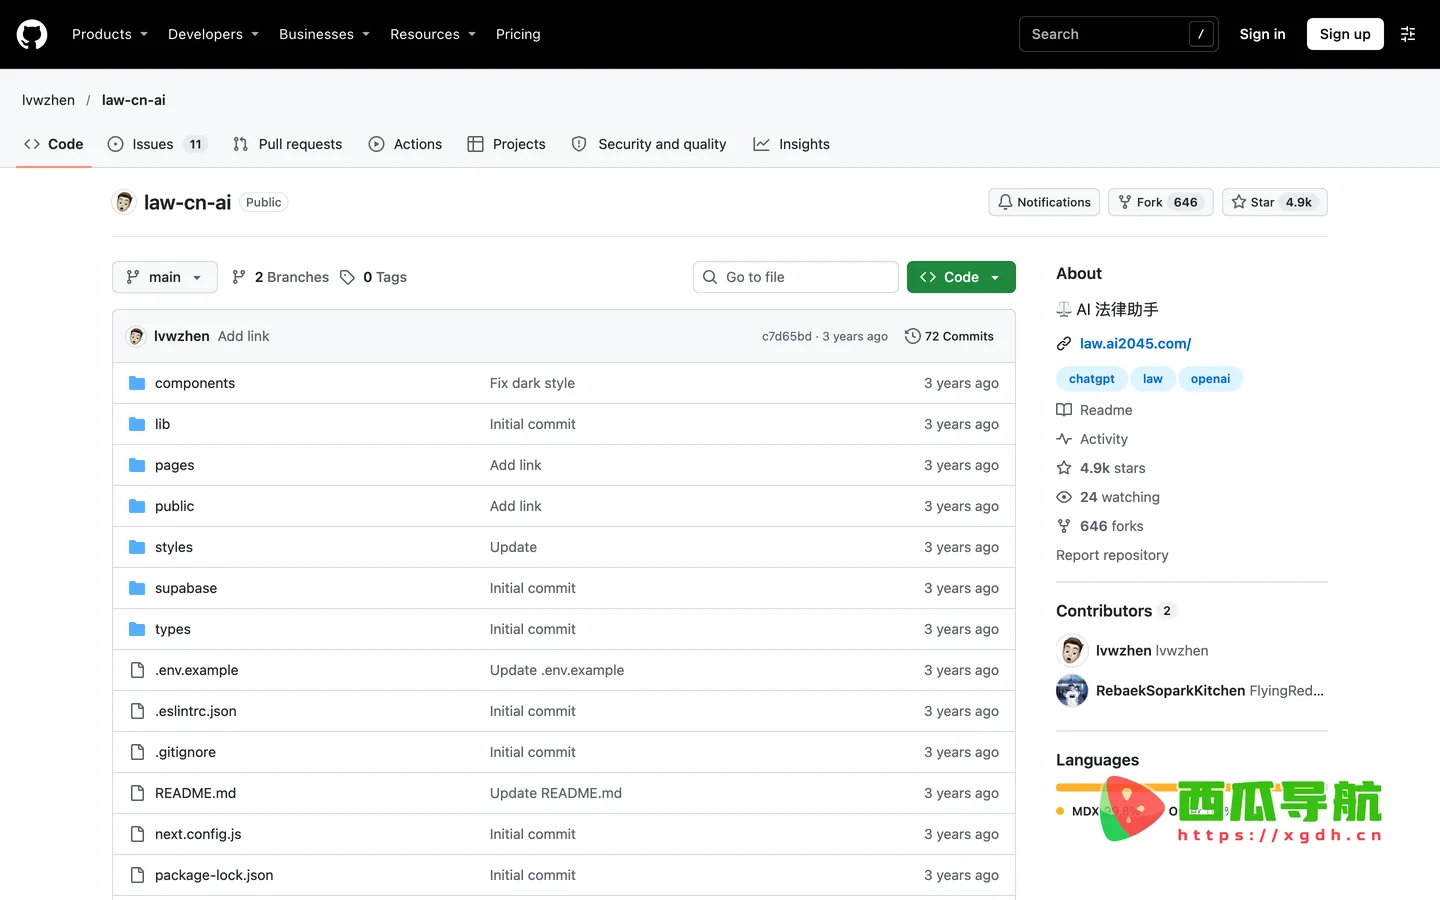
AI 法律助手是一个面向中文法律文本的开源问答项目,主要用来把法律文件预处理成可被检索的知识库、再结合大模型生成回答,服务于想快速查条文、做法律科普或研究检索增强问答的人。它本身并不重新撰写法律内容,而是把现成的法律文件加工成上下文,让提问能够落到具体的文本依据上。项目以开源仓库的形式公开,README 已由 ChatGPT 翻译为中文,页面还保留了 Star History 记录。
核心功能
- 法律文件知识库——把 pages 目录中的 .mdx 文件统一预处理成自定义上下文,让提问有明确的文本依据。
- 向量相似性检索——在 PostgreSQL 里用 pgvector 存储嵌入向量,运行时先找出与问题最相关的内容再作答。
- 流式问答输出——把检索到的内容注入 GPT-3 文本补全,并把回答逐字流式传回客户端。
- 增量嵌入更新——为每个文件生成校验值并存进另一张表,只有文件改动时才重新生成向量,省去重复计算。
- 一键部署集成——部署到 Vercel 时由 Supabase 集成自动设置环境变量与数据库 Schema。
- 本地开发链路——提供从复制环境文件、启动 Supabase 到跑起 Next.js 应用的完整步骤。
使用场景
| 人群/角色 | 场景描述 | 推荐指数 |
|---|---|---|
| 法律从业者 | 输入条文关键词快速定位相关文本,减少翻找纸质或网页资料的时间 | ★★★★☆ |
| 法学生与研究者 | 用自然语言提问法律概念,借助检索到的原文片段辅助学习与写作 | ★★★★☆ |
| 独立开发者 | 照着开源代码搭建属于自己的中文知识库问答,理解检索增强链路 | ★★★★★ |
| 内容创作者 | 把法律科普选题交给问答原型,先拿到可核对的文本依据再整理成稿 | ★★★☆☆ |
| 团队技术负责人 | 评估向量检索加大模型这一方案在本地化法律场景中的可行边界 | ★★★★☆ |
操作指南
- 打开项目仓库页面,确认 README 中已经写明法律文件来自开源法律文本仓库、并基于 Supabase 的文档搜索模板改造。
- 把代码拉到本地,先执行 cp .env.example .env 生成环境文件,再在新文件里填入自己的 OPENAI KEY,这是后续一切调用的凭证。
- 确保本机已安装并运行 Docker,然后在项目目录启动 Supabase;数据库结构与 pgvector 扩展会在 supabase start 时自动应用到本地实例。
- 构建阶段会自动运行 generate-embeddings 脚本,把 pages 目录中的 .mdx 文件转成向量写进 PostgreSQL,并为每个文件记录校验值,重复构建不会白算一遍。
- 另开一个终端窗口启动 Next.js 应用,待服务起来后即可在页面里输入问题,观察 SearchDialog 组件把请求送到向量检索边缘函数的全过程。
- 若想对外提供服务,只需把这套 starter 部署到 Vercel,Supabase 集成会接管环境变量与数据库 Schema 的配置,你仍然要记得补上 OPENAI KEY。
- 上手前建议先读完 README 里的技术细节,照着四步链路核对构建时间与运行时的分工;想直接看效果可以点 立即使用 进入 AI 法律助手。
支持平台
从公开说明看,项目是一个部署在 Vercel 上的 Next.js Web 应用,问答由客户端组件与向量检索边缘函数配合完成;本地则借助 Docker 运行 Supabase 来提供 PostgreSQL 与 pgvector 环境。至于独立客户端、小程序、浏览器插件等形态,站方没有明确列出。
产品定价
站方未公开价格信息,以站内为准。页面底部设有打赏赞助入口,那是读者对作者的自发支持方式,并不是项目的使用标价;需要自己准备的是 OPENAI KEY,这一步在配置环境文件时就会用到。
常见问题
Q:这个项目的法律内容从哪里来?
项目页面写明法律文件来自开源法律文本仓库,README 还点出了所用的文档搜索项目模板;它把 pages 目录中的 .mdx 文件加工成上下文,而不是自行编写法律条文。
Q:为什么构建一次之后不需要每次都重新生成向量?
generate-embeddings 脚本在生成嵌入向量的同时,会为每个 .mdx 文件计算一个校验值并存到另一张数据库表里,只有检测到文件发生变化时才重新生成对应向量,因此重复构建不会重复消耗计算。
Q:本地跑起来需要哪些前置条件?
需要先复制环境文件并填入 OPENAI KEY,本机还要安装并保持 Docker 运行,以便启动 Supabase;执行 supabase start 时,数据库初始化与 pgvector 扩展设置会自动落到本地 PostgreSQL 实例,之后再启动 Next.js 应用即可。
开发者小结
law-cn-ai 的取舍很清晰:它不做法律条文的重新整理,只把现成文件当作知识底座,用构建时间与运行时两段式链路换取结构上的简单,代价是回答质量受限于原始文件质量与向量检索的命中情况,也需要使用者自己准备模型密钥。它适合用来学习检索增强问答的完整拼法、验证中文法律语料接入向量库的可行性;若追求开箱即用的稳定法律咨询产品,还要在内容核对、出处标注与合规上另行投入。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...